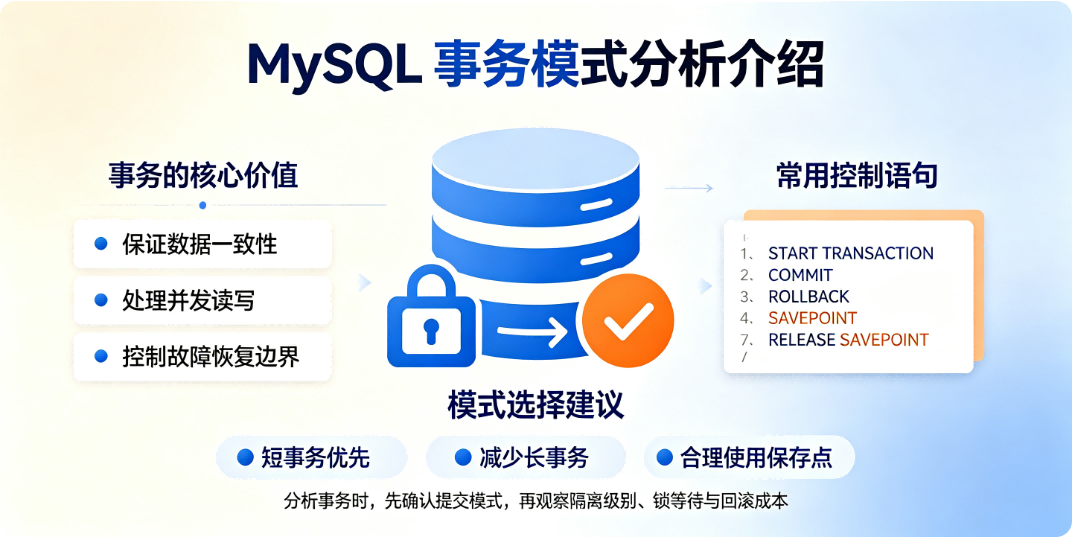
MySQL InnoDB 引擎下,事务相关分为:自动提交模式、事务隔离级别、事务访问模式(只读 / 读写)、保存点、隐式事务几个概念。 1. 自动提交模式 autocommit 控制 SQL 是否自动提交事务,默认开启 autocommit=ON autocommit=1(ON):每条 DML 语句
 发布于 2026-08-24
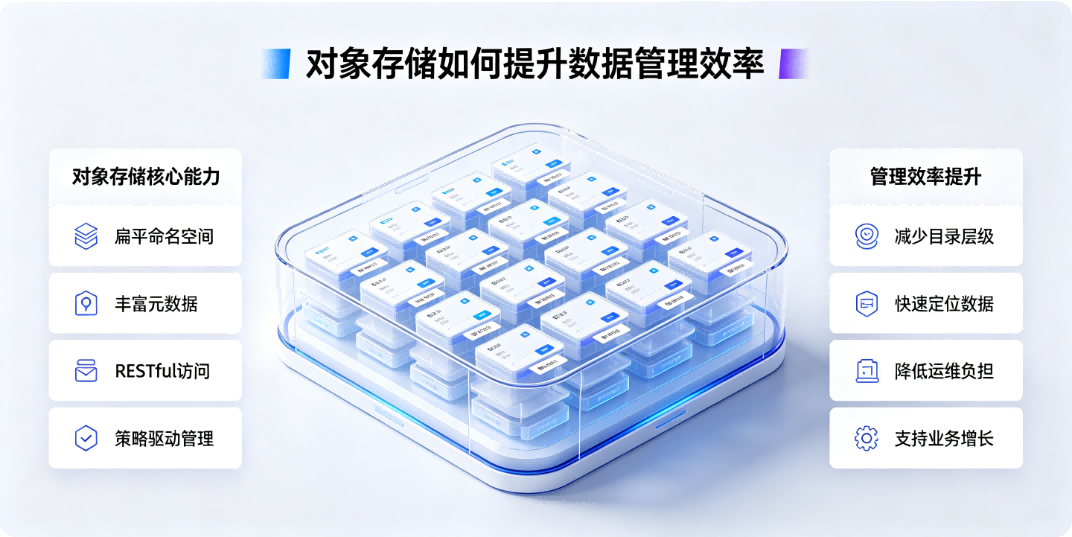
对象存储以对象为最小单元,区别于块存储、文件存储,通过元数据、扁平命名空间、水平扩展、生命周期策略等能力,从存储架构、数据组织、自动化运维、业务访问、合规治理多个维度提升整体数据管理效率,下面分核心能力、落地手段、实践要点说明。 一、架构层面:从底层简化数据管理 扁平命名空间,无目录层级限制 文件存
发布于 2026-08-24
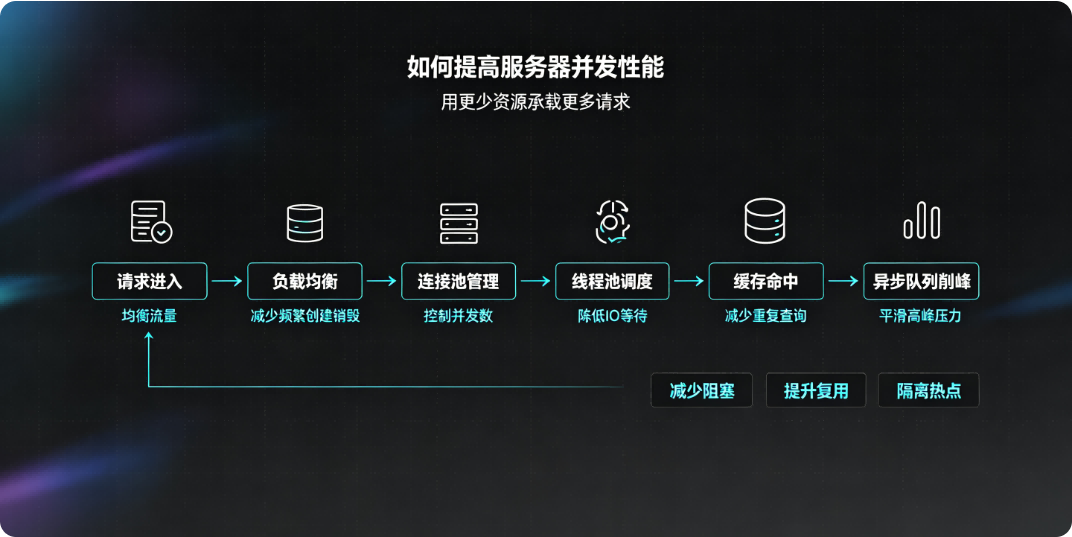
并发本质:单位时间处理更多请求,同时控制 CPU、内存、IO、网络、锁竞争、数据库压力,避免瓶颈。优化分为:架构层、应用层、中间件、数据库、操作系统、网络、硬件七个维度。 一、操作系统层面优化(Linux) 1. 文件句柄与进程限制 高并发下大量连接会耗尽 fd,调大最大打开文件数 # 临时生效 u
发布于 2026-08-24

🔥1. 匿名"牛来大模型"Ox Alpha 被扒出智谱血缘:Tokenizer、视频编码、API 报错全对上 — 热度 🔥🔥🔥🔥🔥 全世界刷屏的"牛来大模型"到底是谁家的牛?8 月 20 日它匿名出现在 OpenRouter 上(模型名 Ox Alpha,104.86 万 token 上下文、单次最
发布于 2026-08-23
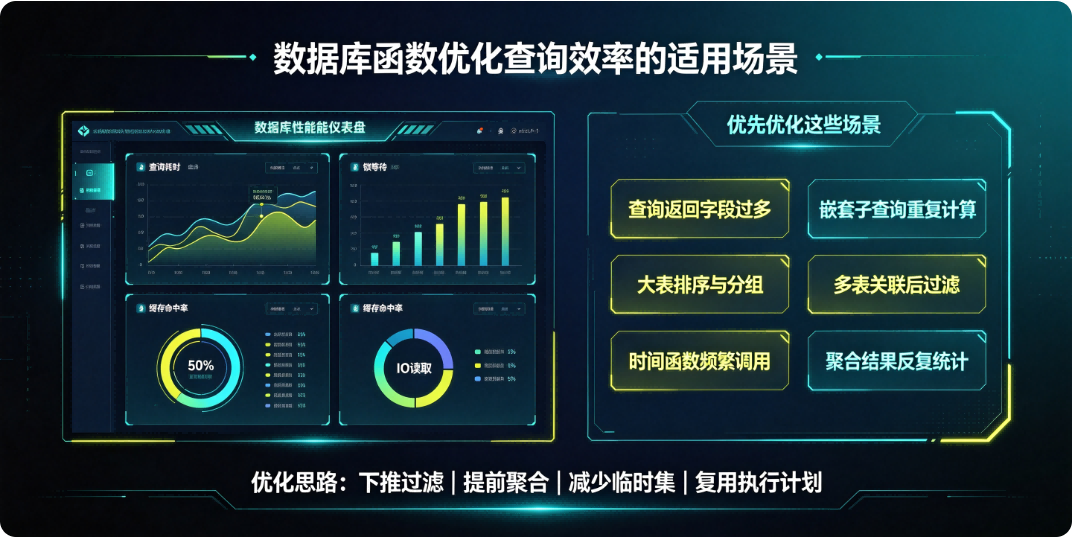
注意:数据库函数本身不是万能,很多场景下函数会造成索引失效;只有合理使用,才能提升查询效率,下面区分「适合用函数提速」和「避坑点」。 一、适合用数据库函数优化查询的场景 1. 聚合统计场景(聚合函数) 业务需要统计汇总,避免把大量原始数据拉到
发布于 2026-08-23
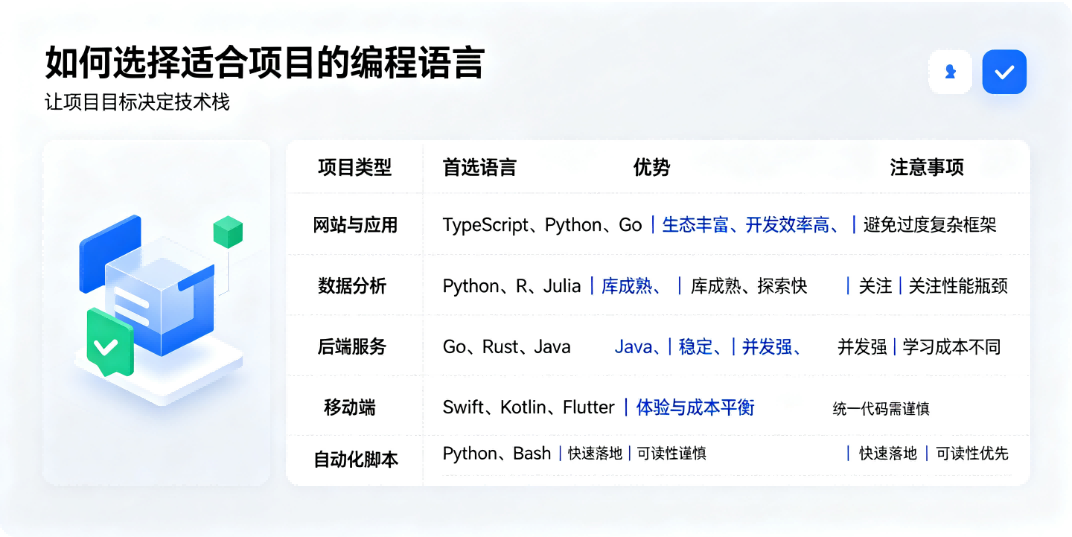
没有绝对最好的语言,只有最匹配项目约束、团队现状、业务场景、长期维护成本的语言。下面从决策维度、场景选型、权衡取舍、避坑思路完整梳理。 一、先明确核心约束(选型优先看这些,而不是语言特性) 先列条件,再挑语言,不要反过来先喜欢某门语言再硬套项目。 业务场景是什么
发布于 2026-08-23
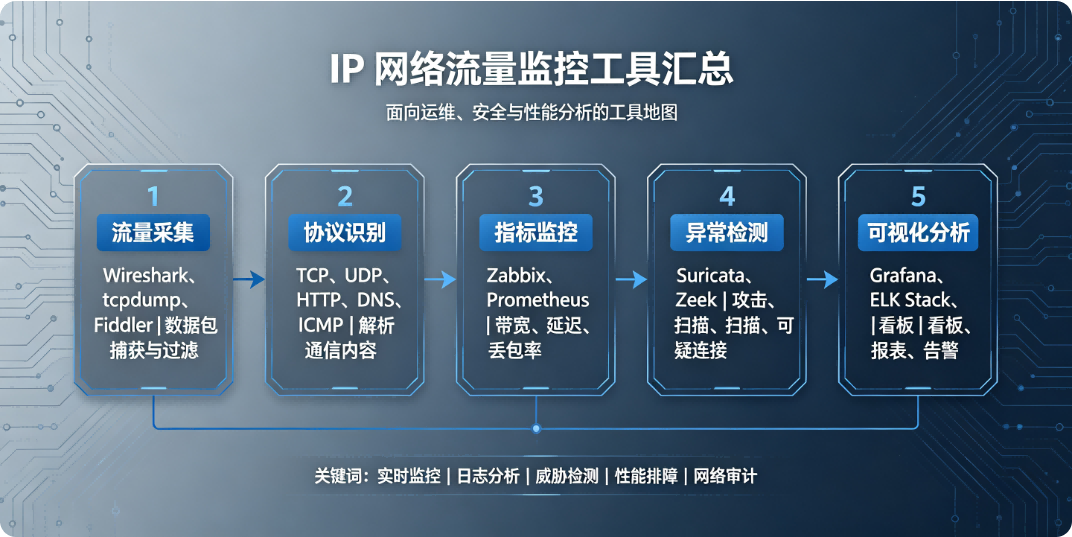
分为单机命令行工具、Web 可视化流量分析、时序监控平台、抓包深度分析、商业工具五大类,区分单机监控、全网(局域网)监控场景稀土掘金。 一、Linux 单机命令行(服务器本机流量,快速排障)
发布于 2026-08-23
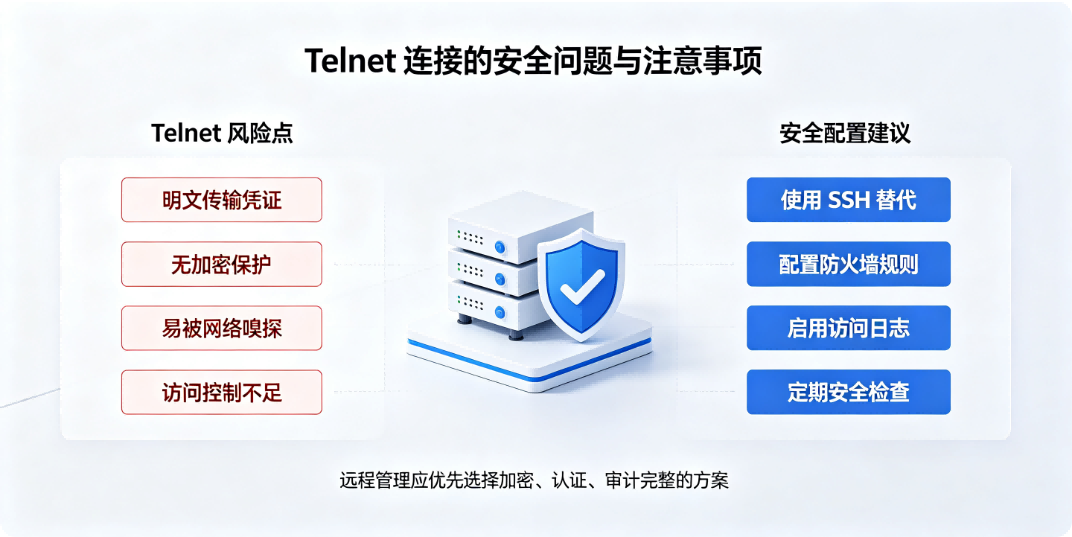
Telnet 是明文传输的远程登录协议,端口默认TCP 23,所有账号、密码、交互数据全部以明文在网络传输,本身安全性极差,生产环境不推荐使用。 一、核心安全风险 账号密码明文泄露 所有报文不加密,网络抓包(Wireshark)可直接截获用户名、密码、输入的命令、返回结果。内网、公网环境下一旦被嗅探
发布于 2026-08-23
🔥1. 不是 Demo!优必选把客户产线 1:1 搬进 WRC:近十台工业人形机器人全天候真干活 — 热度 🔥🔥🔥🔥🔥 优必选在本届 WRC 没有只带明星机器人,而是直接把客户工厂的真实作业场景 1:1 摆上展台:工业人形机器人 Cruzr Y1 持续拆垛码垛、Cruzr S2 给汽车机加件钣金件上
发布于 2026-08-23
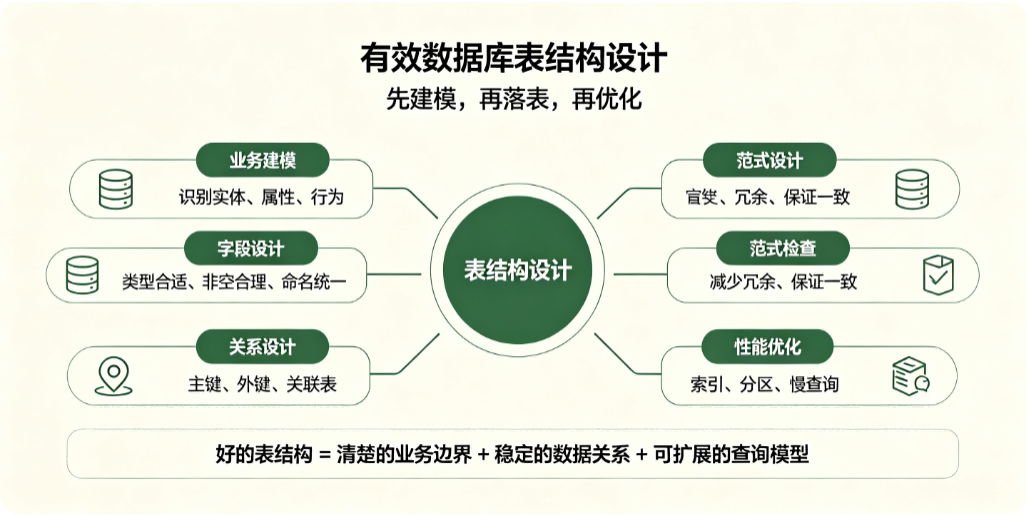
数据库表设计核心目标:合理存储、减少冗余、保证数据一致性、查询性能好、易于扩展、满足业务约束,通用流程:业务分析 → 概念模型 → 逻辑模型 (范式 + 反范式权衡) → 物理表设计 → 索引、约束、分库分表、评审优化。下面结合实战,包含原则、步骤、字段设计、主键外键、范式取舍、常见坑、示例。 一、
发布于 2026-08-22
设计高效的软件架构,本质是在业务需求、技术约束、团队能力之间做最优权衡,目标是实现全生命周期的效率提升—— 不仅是系统运行性能高,更要覆盖研发协作、运维部署、长期演进等多个维度。以下是系统化的设计方法论与核心实践。 一、先明确:“高效架构” 的四层内涵 高效不是单一指标,而是综合能力的体现: 研发高
发布于 2026-08-22
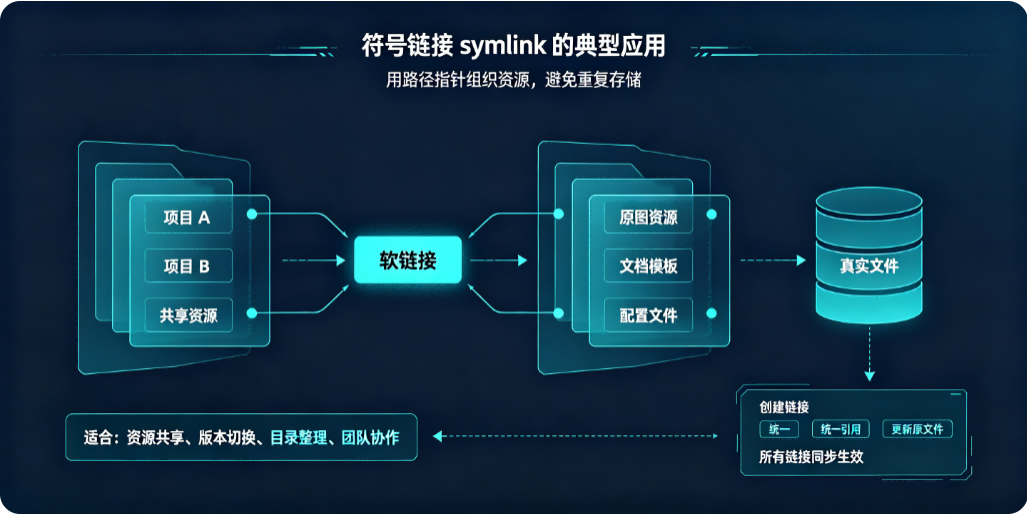
软链接本质是一个特殊文件,里面存储目标文件 / 目录的路径,类似 Windows 快捷方式;删除源文件,软链接会变成无效的 “悬空链接”,不占用实际磁盘数据块。 1. 版本切换(最常用) 同一软件多版本共存,用软链接指向当前使用版本,不用修改环境变量、配置文件。 示例:jdk17、jdk21两个目录
发布于 2026-08-22
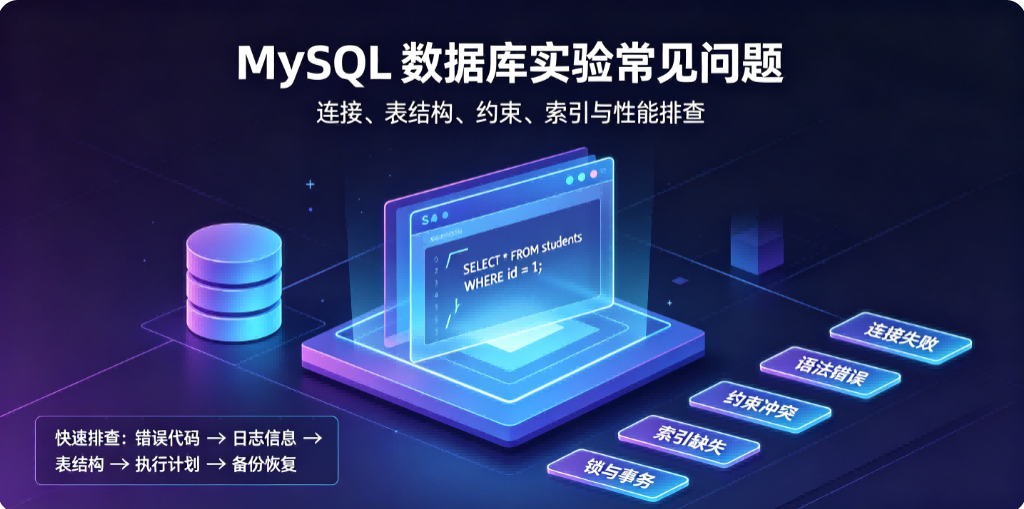
MySQL 课程实验一般包括:建库建表、约束、增删改查、多表连接、子查询、索引、视图、存储过程、权限、备份恢复等,下面整理实验高频报错、踩坑问题、原因和解决办法,适合课程实验报告直接使用。 一、连接登录类问题 Access denied for user 'root'@'localhost' 原因:
发布于 2026-08-21
🔥1. AT&T 披露:40% 的 AI 使用量已跑在开源模型上,编码成本降 56% 质量仅损 2% — 热度 🔥🔥🔥🔥🔥 AINEWS 开发者日报报道最具影响力的企业级信号:AT&T 内部 AI 部署已有 40% 路由到开放模型,目标提升至 60-70%;编码成本下降 56% 而质量仅下降 2%,
发布于 2026-08-21
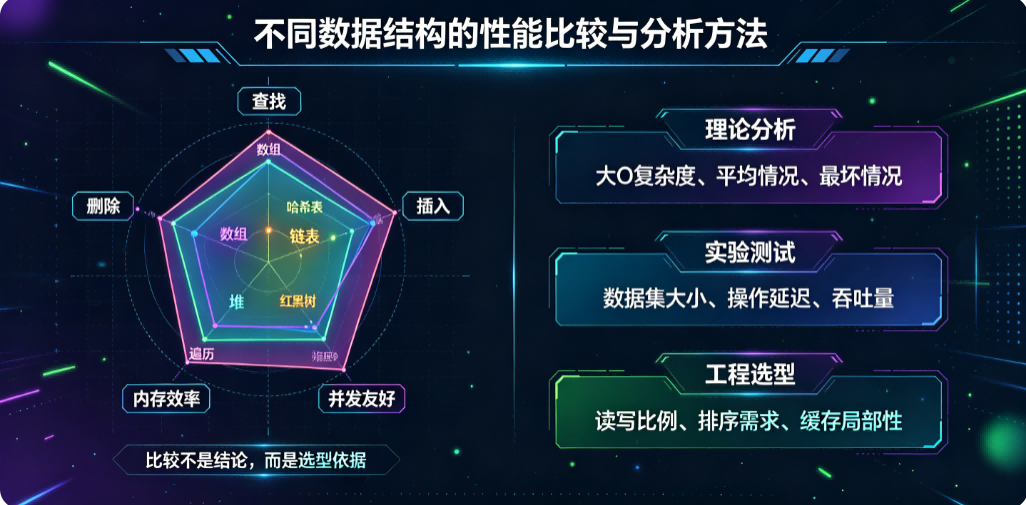
核心思路:从时间复杂度、空间复杂度、实际硬件开销、业务操作场景这四个维度综合评估,不能只看大 O 符号,理论复杂度≠真实性能。 一、基础评价维度 1. 时间复杂度(Big‑O 理论复杂度) 只关注数据规模 n 增长时的增长趋势,忽略常数、低阶项。 常见操作:查找、插入、删除、遍历、随机访问。 表格
发布于 2026-08-21
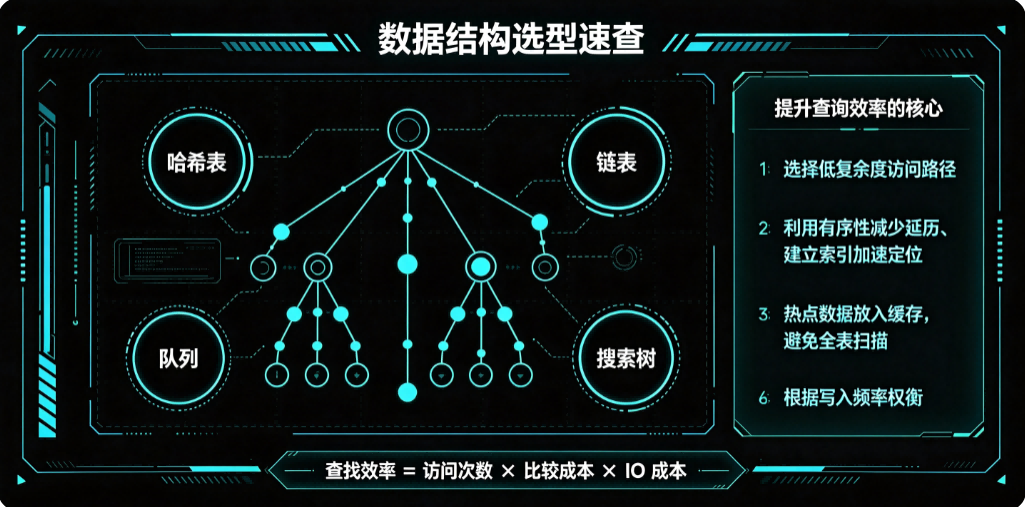
核心思路:先分析查询模式、数据规模、更新频率,再匹配时间复杂度,同时权衡空间开销。查询常见类型:单点查询、范围查询、模糊查询、条件过滤、排序后查询、聚合查询。 时间复杂度记号说明:\(O(1)\)常数、\(O(logn)\)对数、\(O(n)\)线性、\(O(nlogn)\)线性对数 一、先梳理业务
发布于 2026-08-21

