

一、方案概述
1.1 目标
搭建一套高可用、可扩展、支持业务消息生产消费的 Apache Kafka 集群,用于实时数据采集、消息队列、流计算(对接 Flink/Spark)、日志上报等场景;配套 ZooKeeper(Kafka 2.8+ 支持 KRaft 无 ZK 模式,方案同时提供两种选型)。
说明:Kraft 模式推荐新版本(3.3+),消除 ZK 单点瓶颈,运维更简单;传统 ZK 模式适合存量业务迁移。
1.2 核心能力指标
可用性:集群可用性 ≥99.95%,单 Broker 宕机不影响读写
消息可靠性:支持至少一次、精确一次语义,副本自动同步
扩容:支持横向新增 Broker 节点,分区自动迁移
运维:监控、告警、日志收集、权限控制、备份恢复
1.3 环境选型建议
表格
硬件参考(单 Broker):
8 核 16G,SSD 1TB;中小业务(日消息量≤10 亿)
16 核 32G,SSD 2TB;中大型业务(日消息 10~50 亿)
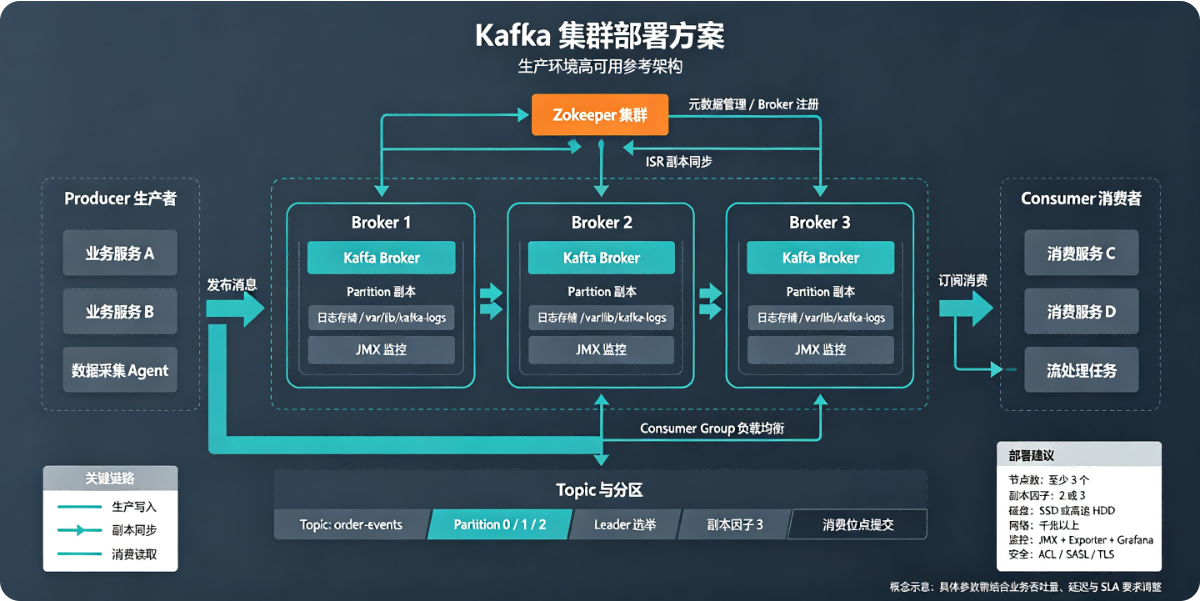
二、集群拓扑设计
方案 A:KRaft 模式(推荐新集群,无 ZooKeeper)
KRaft 分为 Controller 节点 和 Broker 节点,Controller 负责元数据管理。
Controller:3 台(奇数,保证选主,Controller 不承载业务消息)
Broker:3 台起步,生产环境建议 ≥3,根据业务扩容
最小集群:3 节点,每节点同时充当 Controller+Broker(小规模);大规模集群 Controller 独立 3 台,Broker 单独多台。
方案 B:传统 ZooKeeper 模式(存量兼容)
ZK 集群:3 节点(奇数,ZK 不建议 5 节点以上)
Kafka Broker:≥3 节点
ZK 只保存元数据,不存储消息,ZK 压力小,但 ZK 本身是运维负担。
下面方案默认采用 KRaft 3 节点混合部署(Controller+Broker),最小生产集群。
三、网络与端口规划
网络规划要点
内网通信优先,生产环境不要公网暴露 9092;如需外部访问配置
advertised.listeners防火墙放行节点之间 9092、9093 端口;
主机名配置:所有节点
/etc/hosts配置互相解析,避免 DNS 抖动;关闭防火墙 / SELinux,或做白名单。
四、系统层优化(非常关键,Kafka 对系统参数敏感)
4.1 文件句柄 & 进程数
# /etc/security/limits.conf
* soft nofile 1048576
* hard nofile 1048576
* soft nproc  204800
* hard nproc  204800
4.2 sysctl 内核参数
# /etc/sysctl.conf
# 网络调优
net.core.rmem_max=26214400
net.core.wmem_max=26214400
net.ipv4.tcp_rmem = 4096 87380 16777216
net.ipv4.tcp_wmem = 4096 65536 16777216
net.ipv4.tcp_syncookies=1
net.ipv4.tcp_tw_reuse=1

# 内存调优
vm.swappiness=1                # 关闭swap,Kafka禁用swap
vm.dirty_background_ratio=5
vm.dirty_ratio=10
vm.max_map_count=262144
执行生效:sysctl -p
4.3 磁盘挂载优化
数据盘挂载选项:noatime,关闭访问时间记录
# /etc/fstab
/dev/sdb /data/kafka ext4 defaults,noatime 0 0
禁止使用
atime,会大量损耗 SSD 寿命;磁盘单独分区,日志和数据分开。
五、Kafka 安装与配置(KRaft 3 节点示例)
节点主机名:kf-01、kf-02、kf-03 节点 IP:192.168.1.101、192.168.1.102、192.168.1.103 数据目录:
/data/kafka
5.1 解压安装
# 下载 kafka_2.13-3.7.0.tgz
tar -zxvf kafka_2.13-3.7.0.tgz -C /opt/
cd /opt/kafka_2.13-3.7.0
mkdir -p /data/kafka
5.2 生成集群唯一 ID(只执行一次)
bin/kafka-storage.sh random-uuid
# 输出示例:abcdefghijklmnopqrstuvwxyz
5.3 节点配置文件 config/kraft/server.properties
kf-01
# 节点ID,每个节点唯一
node.id=1
# 控制器节点列表,全部3个controller
controller.quorum.voters=1@192.168.1.101:9093,2@192.168.1.102:9093,3@192.168.1.103:9093
# 监听地址
listeners=PLAINTEXT://192.168.1.101:9092,CONTROLLER://192.168.1.101:9093
advertised.listeners=PLAINTEXT://192.168.1.101:9092
# 集群uuid,上面生成的
cluster.id=abcdefghijklmnopqrstuvwxyz
# 角色:混合部署,controller+broker
process.roles=broker,controller
# 数据目录
log.dirs=/data/kafka
# 分区副本默认配置
default.replication.factor=3
min.insync.replicas=2
# 消息保留时长
log.retention.hours=72
# 单日志段大小
log.segment.bytes=1073741824
# 开启自动创建topic(生产建议关闭 auto.create.topics.enable=false)
auto.create.topics.enable=false
# JVM参数在kafka-server-start.sh配置
kf-02 node.id=2,IP 改为 102;kf-03 node.id=3,IP 改为 103,其余一致。
5.4 JVM 参数 bin/kafka-server-start.sh
export KAFKA_HEAP_OPTS="-Xms16G -Xmx16G -XX:+UseG1GC -XX:MaxGCPauseMillis=200"
内存建议:不超过机器物理内存 50%,留内存给操作系统 PageCache。Kafka 大量依赖 OS 页缓存。
5.5 格式化存储(KRaft 必须执行,只做一次)
bin/kafka-storage.sh format -t abcdefghijklmnopqrstuvwxyz -c config/kraft/server.properties
5.6 启动 & 自启(systemd)
# /etc/systemd/system/kafka.service
[Unit]
Description=Apache Kafka Server
After=network.target

[Service]
Type=simple
User=kafka
WorkingDirectory=/opt/kafka_2.13-3.7.0
ExecStart=/opt/kafka_2.13-3.7.0/bin/kafka-server-start.sh /opt/kafka_2.13-3.7.0/config/kraft/server.properties
ExecStop=/opt/kafka_2.13-3.7.0/bin/kafka-server-stop.sh
Restart=on-failure

[Install]
WantedBy=multi-user.target
systemctl daemon-reload
systemctl enable kafka
systemctl start kafka
5.7 集群验证
# 创建topic,3副本,6分区
bin/kafka-topics.sh --create --topic demo_topic --bootstrap-server 192.168.1.101:9092,192.168.1.102:9092,192.168.1.103:9092 --partitions 6 --replication-factor 3

# 查看topic
bin/kafka-topics.sh --describe --topic demo_topic --bootstrap-server 192.168.1.101:9092
六、关键业务参数设计
6.1 Topic 分区与副本
副本数 replication.factor:生产固定 3,至少 2;副本不能大于 Broker 数量
最小同步副本 min.insync.replicas:副本 3 时设置为 2;生产者
acks=all,保证写入至少 2 个副本成功才返回分区数:分区决定并行度;分区数建议:Broker 数 × (2~4)。分区不要过大(上万分区会增加 Controller 元数据压力)
消费并行度 = 消费者组内消费者数量,最多等于分区数量。
6.2 消息可靠性参数
生产者:
acks=all
retries=10
enable.idempotence=true  # 幂等,防止重复消息
消费者:
enable.auto.commit=false # 关闭自动提交,业务处理完成手动提交offset
isolation.level=read_committed
6.3 消息保留策略
按时间:
log.retention.hours按大小:
log.retention.bytes
满足任一条件就清理旧消息;重要业务可以开启消息压缩
compression.type=lz4,降低 IO。
七、监控体系
7.1 指标采集
Kafka 暴露 JMX 指标,接入 Prometheus + Grafana,使用 kafka_exporter。 重点监控项:
Broker 状态、副本是否同步 UnderReplicatedPartitions(核心告警指标,出现代表副本异常)
Topic 消息流入流出速率、分区 leader 分布
生产 / 消费延迟(consumer lag,最核心业务指标)
磁盘使用率、磁盘 IO、网络带宽
JVM GC、内存、文件句柄数
7.2 告警规则
UnderReplicatedPartitions >0 紧急告警
Consumer Lag 持续上涨
磁盘使用率 >85%
Broker 进程宕机
Controller 节点异常
八、权限与安全(生产必选)
SASL 认证:PLAIN / SCRAM,客户端连接必须账号密码,禁止匿名访问
ACL 权限:Topic 维度,控制用户读写权限
传输加密:SSL/TLS 加密通信
网络:内网隔离,只允许业务服务器访问 Kafka 端口
九、扩容方案
新增 Broker 节点:部署同版本 Kafka,加入 KRaft quorum(扩容 Broker 不需要新增 Controller)
分区迁移:使用
kafka-reassign-partitions.sh,把分区均衡迁移到新节点,负载均衡扩容注意:迁移分区会占用磁盘与网络带宽,业务低峰操作
十、备份与容灾
Offset 备份:定期导出消费者组 offset,故障可恢复
消息备份:重要 Topic 可镜像到备用集群(MirrorMaker2 跨集群同步)
故障演练:单 Broker 停机,验证业务读写不受影响
十一、灾备方案
同城双集群:主集群写入,MirrorMaker2 同步到备集群;故障时切换业务到备用集群
不推荐跨机房单集群:网络延迟高,副本同步不稳定
十二、容器化部署(可选)
Docker 部署适合测试环境;生产容器部署注意:
使用宿主机本地 SSD 挂载,不要使用容器存储;
KRaft 集群要固定 node.id,不要动态销毁重建;
K8s 部署使用 StatefulSet,稳定网络标识。
十三、风险点与避坑清单
✅ 不要用机械盘,磁盘 IO 是 Kafka 最大瓶颈 ✅ 一定要关闭 swap ✅ 副本数不能大于 Broker 数量 ✅ 不要单节点部署生产集群 ✅ 分区不要一次性创建几万,压垮 Controller ✅ advertised.listeners 配置错误会导致客户端无法连接,高频踩坑点 ✅ 业务关闭自动创建 topic,统一运维创建 topic
十四、交付物清单
集群拓扑图(Mermaid)
主机资源清单
完整配置文件模板
系统优化脚本
部署步骤手册
监控面板 Grafana Json
运维手册(启停、扩容、故障排查)
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢