

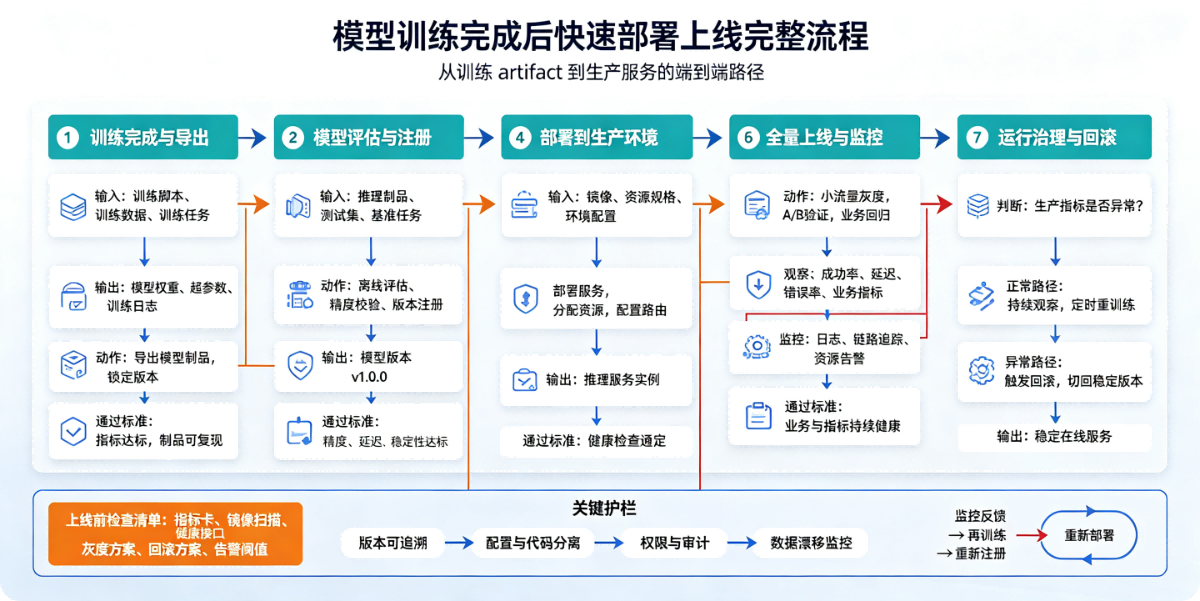
核心思路:模型导出 → 验证推理 → 封装服务 → 部署运行 → 监控灰度,根据场景选轻量 / 生产级方案,优先复用成熟工具减少重复造轮子。下面分通用流程、不同方案选型、踩坑点。
一、第一步:训练收尾 & 模型导出(最容易忽略)
训练框架(PyTorch/TensorFlow/Paddle)原生权重文件不能直接上线,需要导出成推理格式,降低推理开销:
PyTorch:
.pth→ 导出ONNX,或TorchScript;大模型可导出 GGUF、AWQ/GPTQ 量化权重TensorFlow:
.ckpt→ SavedModel通用推荐:优先导出 ONNX,跨框架通用,ONNX Runtime 推理速度好
✅ 必做:离线推理校验 用导出后的模型跑一批测试样本,对比训练时的预测结果,检查精度是否掉点。很多时候导出后出现算子不支持、shape 问题,等到上线才发现。 可选:量化(INT8/INT4),减小模型体积、提速,代价是轻微精度损失。
二、第二步:模型推理服务封装(快速上线核心)
分 3 档方案:极速原型(10 分钟跑通)、轻量生产、高并发生产
方案 1:原型验证,快速跑通 API(适合 Demo、内部测试)
适合:快速给业务方提供 HTTP 接口,不考虑高并发。
FastAPI + 模型直接加载
from fastapi import FastAPI
import onnxruntime as ort

app = FastAPI()
sess = ort.InferenceSession("model.onnx")

@app.post("/predict")
def predict(data: dict):
    # 预处理 -> 推理 -> 后处理
    return {"result": "xxx"}
启动:uvicorn main:app --host 0.0.0.0 --port 8000
优点:上手极快;缺点:单进程,并发差,模型每次只加载一次,多请求会排队。
现成推理框架一键起服务(强烈推荐,不用手写 web)
ONNX Runtime Server:onnx 模型一行命令启动 http/gRPC 服务
TorchServe:PyTorch 官方推理服务,支持模型版本、A/B 测试
TFServing:TensorFlow 官方
大模型场景:vLLM /llama.cpp/ Text Generation Inference(TGI),自带流式输出、批处理
示例 TorchServe 极简流程:
# 打包模型
torch-model-archiver --model-name mymodel --version 1.0 --serialized-file model.pt --handler handler.py
# 启动服务
torchserve --start --model-store model_store --models mymodel=mymodel.mar
方案 2:容器化打包(推荐作为标准上线方式)
把推理服务打包成 Docker,解决环境依赖问题,本地能跑 = 线上能跑。
写 Dockerfile,把模型文件、推理环境、代码打进镜像
本地
docker build、docker run验证接口推镜像到镜像仓库(Harbor / 阿里云镜像仓库)
优势:交付统一,后续无论是裸机、K8s、云 Serverless 都可以直接部署。
方案 3:高并发生产部署(面向正式业务流量)
Kubernetes(K8s):Docker 镜像部署,弹性扩缩容、负载均衡、滚动更新,适合稳定线上业务
云厂商托管推理服务(最快生产交付,不用管底层) 阿里云 PAI、腾讯云 TI-ONE、AWS SageMaker、火山引擎 Triton:上传模型,选推理引擎,一键部署 API。底层自动扩缩容,适合不想维护 K8s 的团队。
Triton Inference Server(NVIDIA):工业级首选。支持多框架模型(ONNX/PyTorch/TensorRT)、动态批处理、模型版本管理、GPU 调度、多模型同时部署。支持 HTTP/gRPC。
三、第三步:部署 + 流量接入
环境准备
小模型:CPU 机器即可
CV/LLM 大模型:GPU,注意 CUDA、驱动版本匹配(容器优先,避免宿主机环境坑)
网络:安全组开放端口,加鉴权(API Key),不要裸暴露公网
负载均衡:多实例部署时前面加 Nginx / 云 LB,分发流量
灰度策略:先小流量测试,验证指标,再全量放量
四、第四步:上线后监控(模型服务和普通服务不一样)
除了常规监控(CPU/GPU、内存、延迟、错误率),模型专属监控:
输入数据分布漂移(Data Drift)
预测结果分布漂移(Concept Drift)
推理精度、置信度分布
样本日志:保存请求、输入、预测结果,方便后续 bad case 复盘
工具:Prometheus+Grafana、Evidently AI、AWS SageMaker Model Monitor 等
五、不同场景选型速查表
六、常见坑(避坑清单)
❗导出模型时算子不支持:尽量用 ONNX opset 稳定版本,复杂自定义算子需要自己实现
❗推理预处理 / 后处理代码和训练时不一致:这是 Top1 精度掉点原因,预处理代码统一
❗模型重复加载:多进程服务不要每个进程都加载模型,模型放共享内存 / 单进程推理
❗GPU 显存溢出:动态批处理、设置最大 batch size,开启量化
❗没有超时控制:推理卡住导致服务雪崩,增加接口超时、熔断
七、极简最短上线路线(追求最快)
训练完成 → 导出 ONNX → 写好预处理后处理 → 使用 ONNX Runtime Server 启动 http 接口 → Docker 打包 → 容器部署到服务器 → API 调用测试 → 加监控、鉴权。
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢