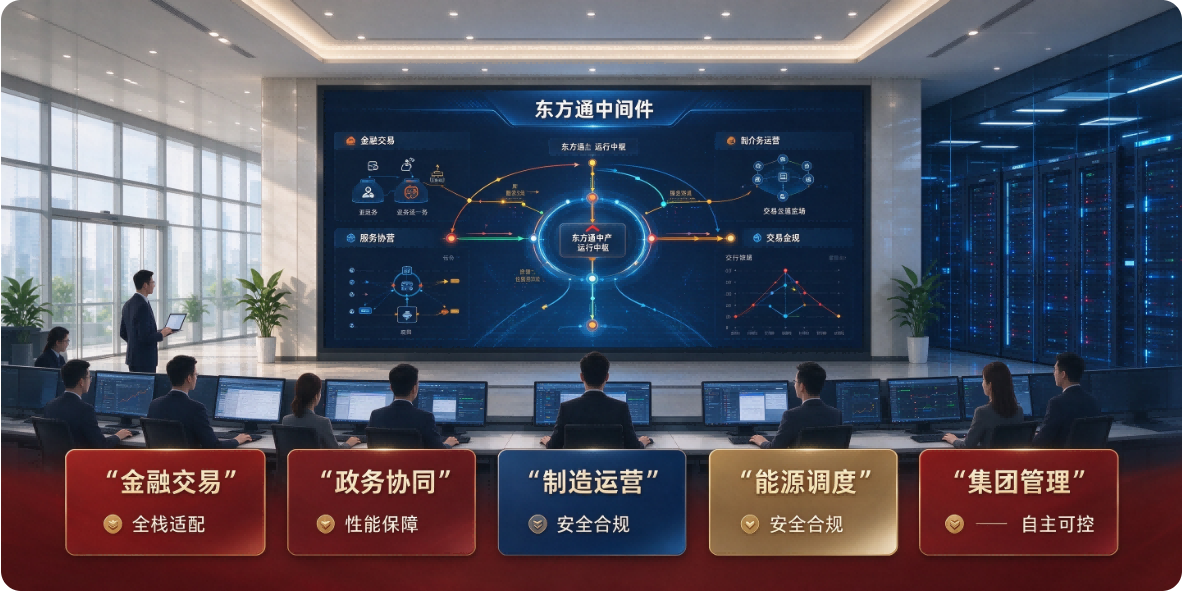
东方通国产中间件(核心:TongWeb 应用服务器、TongLINK/Q 消息中间件、TongEASY 交易中间件、TongESB 服务总线、TongRDS 分布式缓存、TongJDS 任务调度),核心定位是信创底座、异构系统集成、高可用分布式业务支撑,大量落地在政府、金融、交通、能源、医疗、制造、
 发布于 2026-10-17
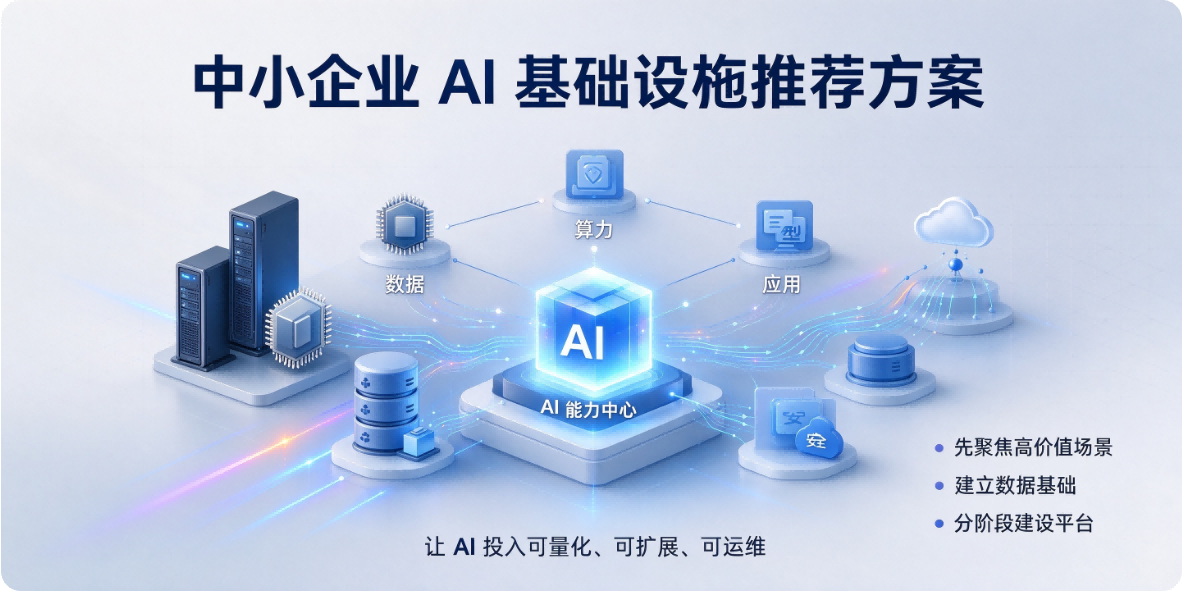
核心思路:优先轻量化、低成本、可按需扩容,不盲目自建大算力集群;分 3 条路线:公有云托管(最快上线)、混合部署(数据敏感)、本地单机 / 小集群(完全私有化)。中小企业痛点:预算有限、缺少专职 AI 运维、数据量不大、业务场景多是 RAG 知识库、OCR、智能客服、文档摘要、简单图像识别,极少需要
发布于 2026-10-17
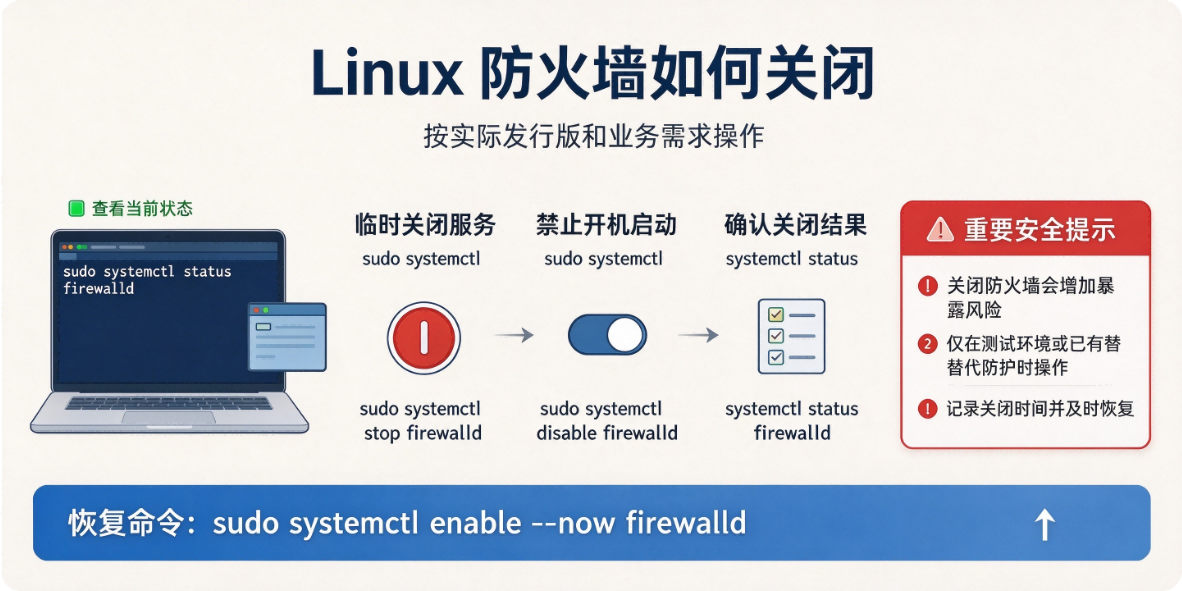
⚠️重要提醒 生产环境不建议直接关闭防火墙,最好是放行端口;关闭仅用于本地测试、集群实验环境。云服务器还要注意云厂商安全组,系统防火墙关了安全组依旧会拦截端口。 一、CentOS7+/RHEL7+/Alibaba Linux(firewalld) # 查看状态 systemctl status fi
发布于 2026-10-17
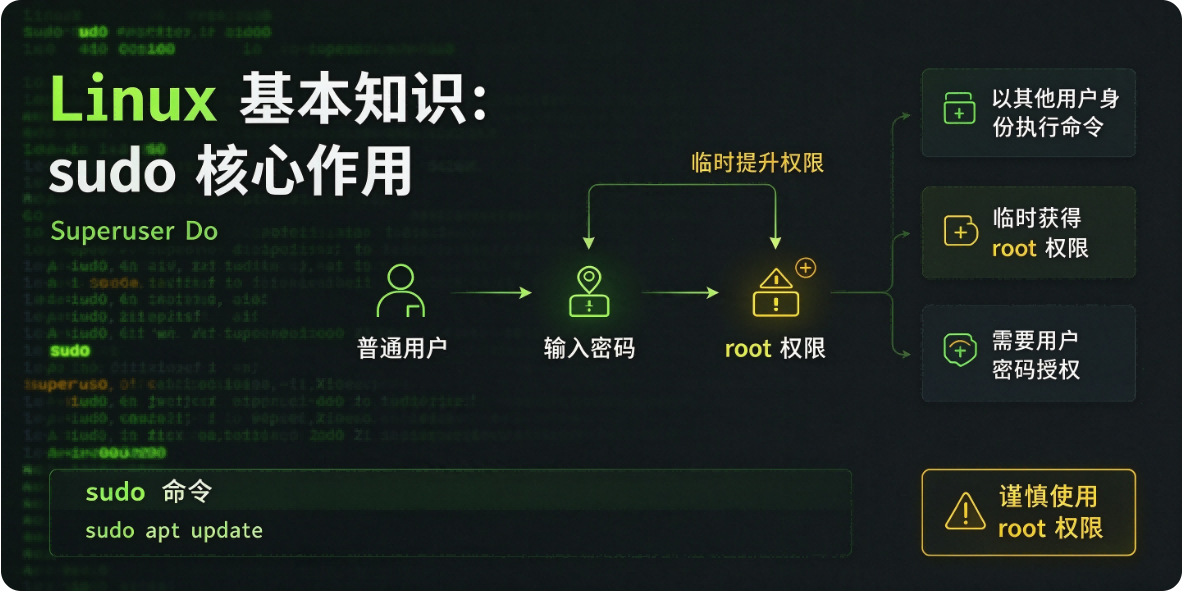
sudo = substitute user do,简单说:以其他用户身份执行一条命令,默认是 root(超级管理员)身份。 核心要点 不是永久切换 root,只临时提权 su 是切换整个会话为 root; sudo cmd 仅这一条命令用管理员权限执行,执行完权限回归普通用户。 权限受控 由 /e
发布于 2026-10-17
主题:同一天,Agent 的"上限"和"下限"同时被推到台前——Gemini 4 与 Muse Spark Open 把模型拉高,而腾讯云上那支失控的 Agent 舰队把安全问题再次钉在桌面上 今天是模型发布日。谷歌的 Gemini 4 Argon 终于落地,Artificial Analysis
发布于 2026-10-17
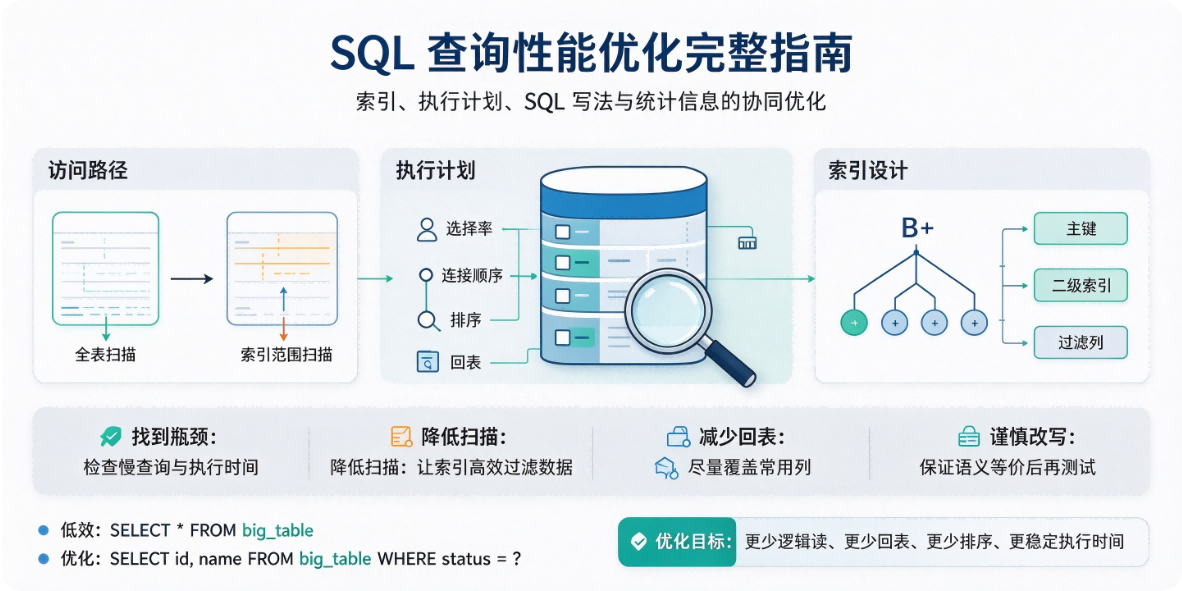
优化思路分为 4 大块:SQL 语句本身优化、索引优化、数据库表结构设计、执行计划与数据库配置,优先从执行计划入手定位瓶颈,不要盲目加索引。 一、先看执行计划(定位问题的第一步) MySQL:EXPLAIN SELECT ... PostgreSQL:EXPLAIN ANALYZE SELECT .
发布于 2026-10-17
核心目标:降低联调成本、减少网络开销、便于版本迭代、易于排查问题、保障安全,下面从规范、数据结构、性能、错误处理、版本、安全、工程实践完整梳理,适合团队落地。 一、接口风格选型 RESTful(最通用,CRUD 场景) 资源用名词复数,不要动词 ✅ GET /users 获取用户列表 ✅ GET /
发布于 2026-10-17
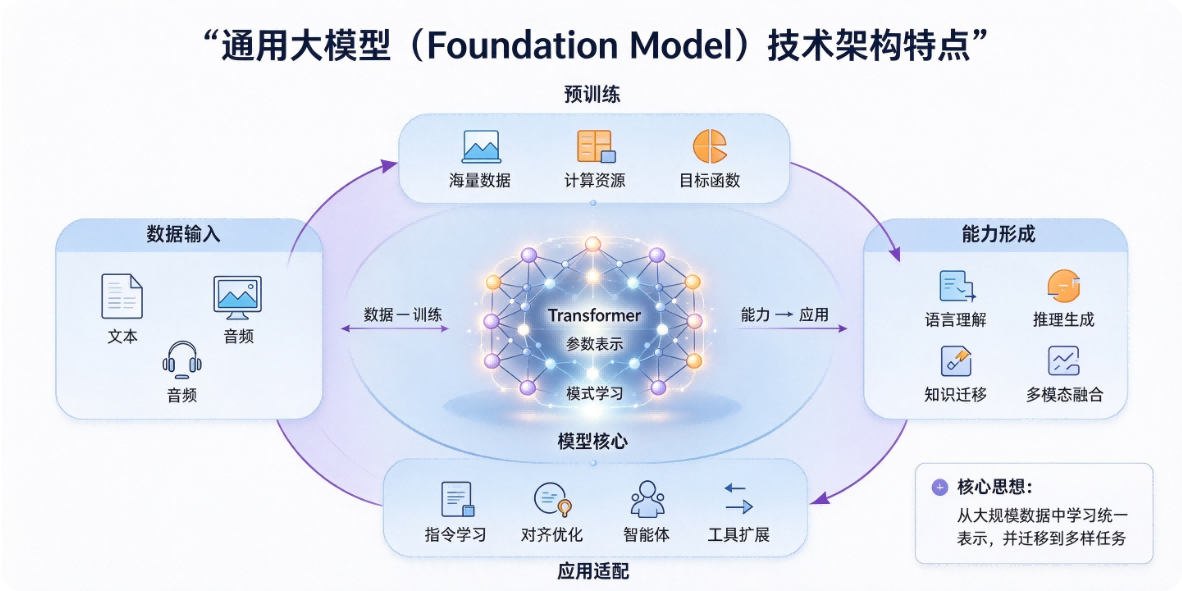
通用大模型,指在海量多源无标注数据上预训练、具备通用知识与泛化能力,可适配大量下游任务的基础大模型,当前主流为 Transformer 架构,下面从分层拆解核心特点: 一、底层基础架构:以 Transformer 为核心骨干 自注意力机制(Self-Attention) 核心能力:建模序列内任意位置
发布于 2026-10-16
核心思路:隔离优先、最小权限、快照兜底、网络分区、边界控制,测试环境不能污染宿主机,测试样本(病毒、恶意脚本、漏洞 POC)不能逃逸到内网 / 互联网。 适用:漏洞复现、Web 安全测试、恶意代码分析、应用功能测试。 一、虚拟化选型
发布于 2026-09-21
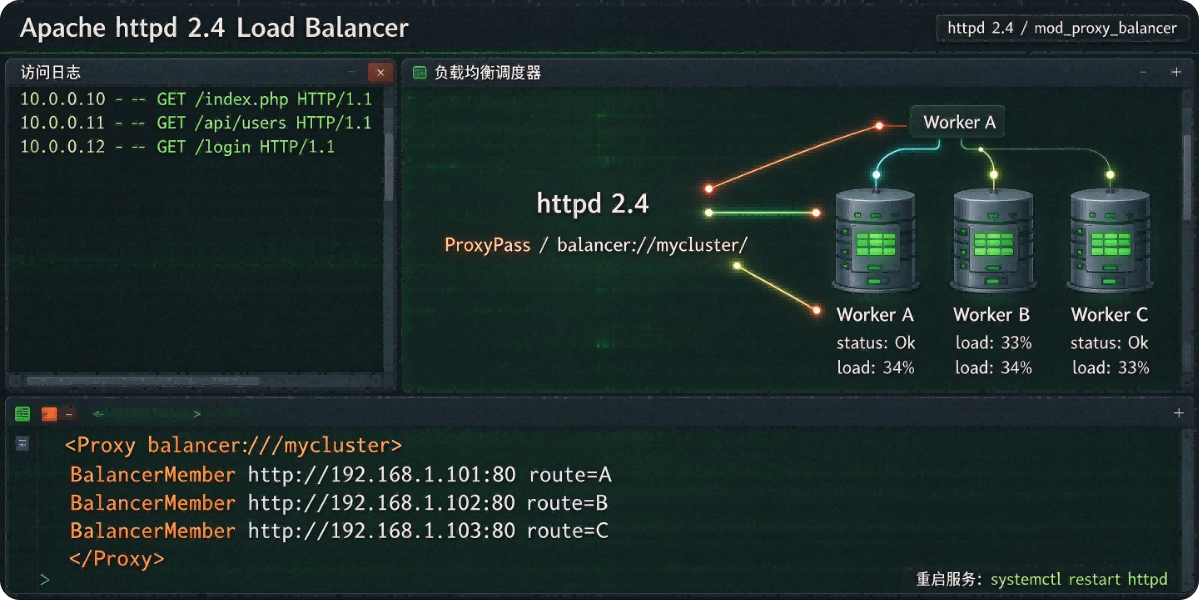
Apache 做七层反向代理负载均衡,核心模块:mod_proxy、mod_proxy_balancer、mod_proxy_http,再加调度算法模块。 原理:Apache 作为入口,接收客户端请求,按策略转发给后端多台 Web / 应用服务器;后端节点故障自动剔除,恢复后自动加回。 一、开启所需
发布于 2026-09-21
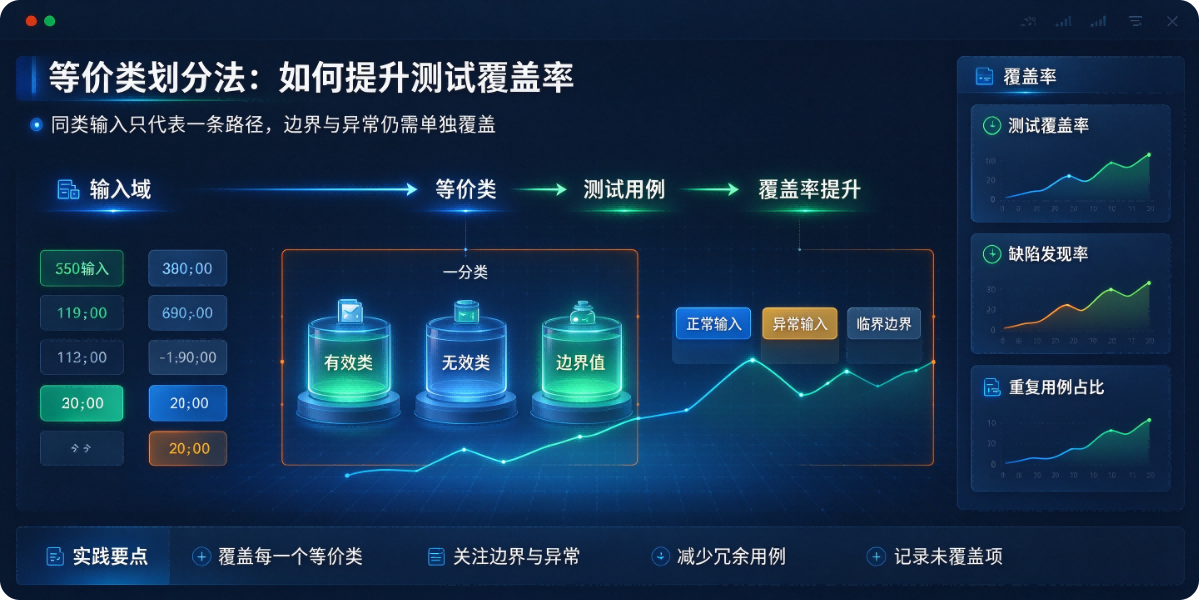
等价类划分是黑盒测试核心用例设计方法。核心思想:把输入域划分成若干等价类,同一类内的数据具有相同处理逻辑,从每个等价类选取代表性数据,用少量用例覆盖大量输入场景,避免穷举测试。 等价类分为:有效等价类(合法输入)、无效等价类(非法输入)。 一、完整实施步骤(落地流程)
发布于 2026-09-21
主题:Jev 从"一个仓库"变成"一个品类",而它的创始人终于露面了——同一天,Gemini 用猜密码进了真实公司 今天的主角仍是 Jev,但性质变了:创始人身份揭晓——前 OpenAI 研究员 Diogo Almeida 创办的 TypeSafe 结束隐身,把 Jev 定义为"System One
发布于 2026-09-21
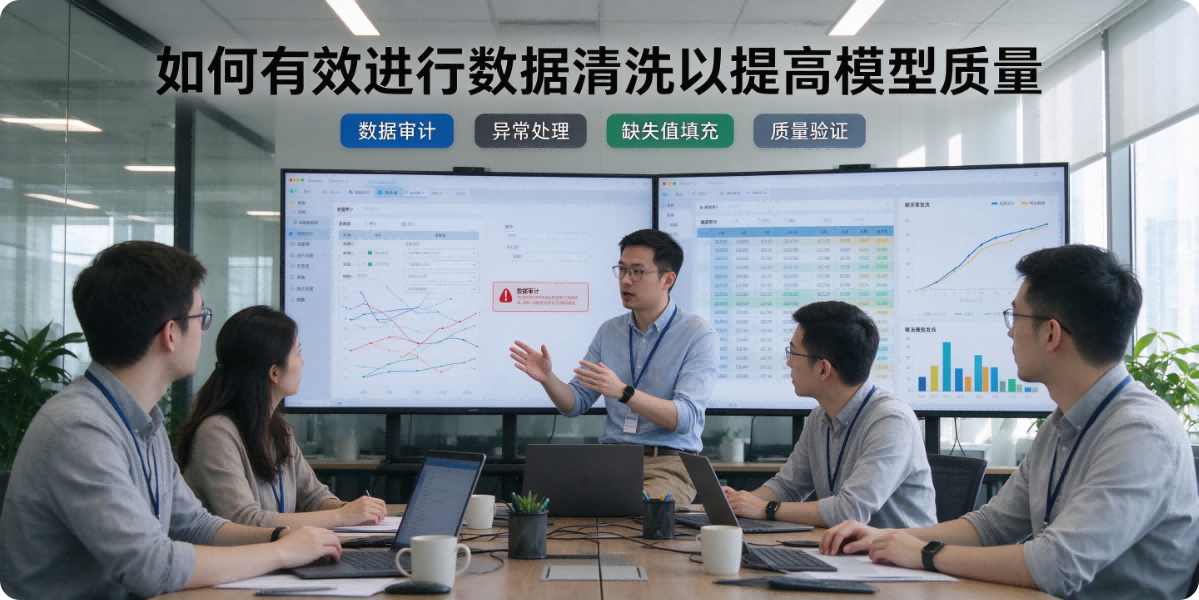
数据清洗的核心目标:修正脏数据、降低噪声、消除数据偏差,让模型学到真实规律而不是数据里的错误和干扰,一般按「评估 → 识别问题 → 清洗处理 → 验证闭环」流程落地。 一、先做数据探查与质量评估(清洗前必做) 不先摸底直接清洗很容易破坏有效信息。 基础统计探查 数值字段:均值、中位数、分位数、方差、
发布于 2026-09-20
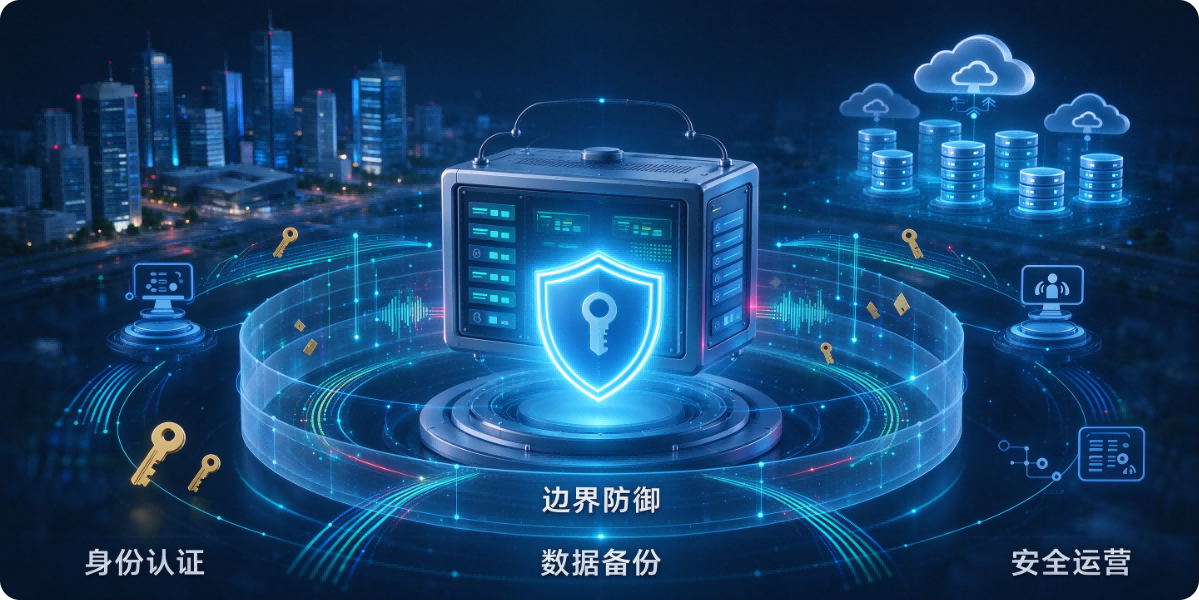
企业级数据安全不是单一产品,而是制度 + 人员 + 技术 + 运营 + 合规的完整闭环,覆盖数据采集、传输、存储、使用、共享、销毁全生命周期。下面从顶层框架、全生命周期技术手段、权限与访问控制、基础设施安全、审计与应急、合规治理几个维度说明。 一、顶层治理:先建立管理体系(安全的根基) 数据分级分类
发布于 2026-09-20
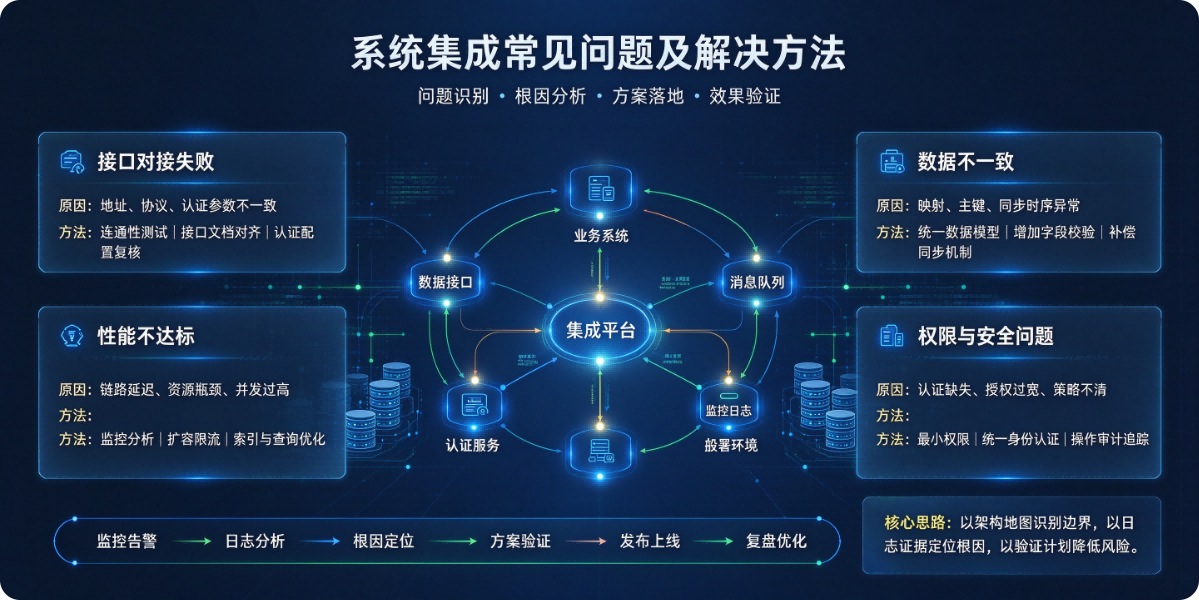
系统集成本质是把硬件、软件、网络、业务系统、第三方接口打通,实现数据互通、业务联动;痛点大多集中在接口、数据、兼容性、性能、运维、需求管理六大类,下面按类别整理问题、原因、解决方案,适合方案编写、汇报、故障排查。 一、接口对接问题(最常见) 1. 接口协议不统一 现象:A 系统用 HTTP/JSON
发布于 2026-09-20
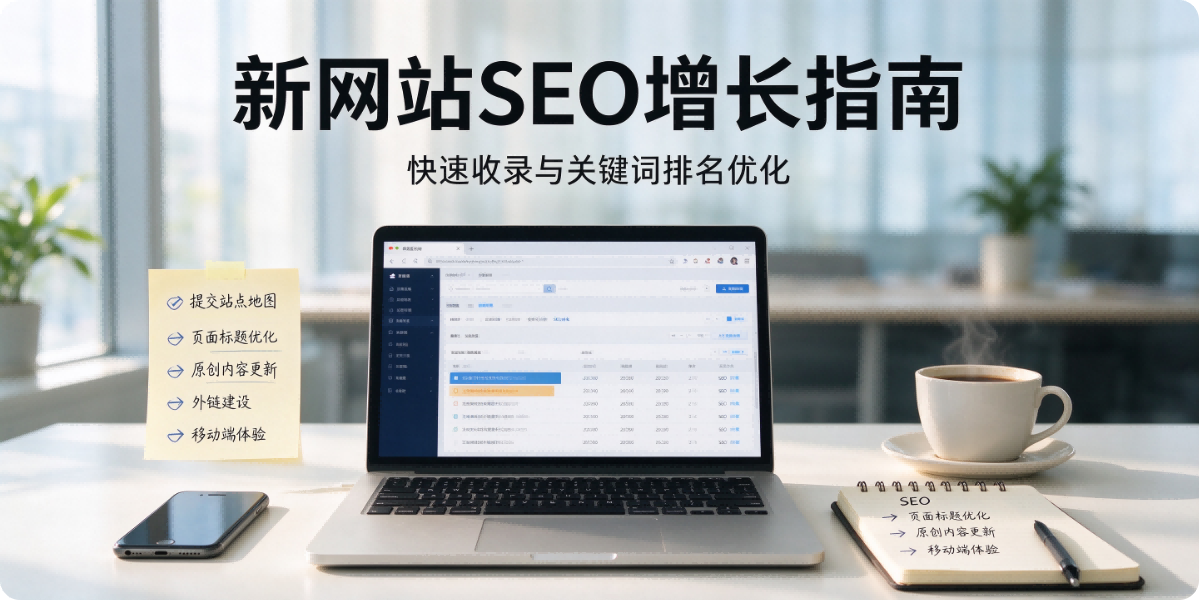
新站核心难点:沙盒期、信任度低、无外链、收录慢,策略优先解决收录,再做关键词排名,不要一上来就堆外链。 一、基础站内 SEO(新站第一优先级,不做好很难收录) 1. 域名与站点基础 域名尽量和业务相关,新域名不要买历史有惩罚的旧域名;
发布于 2026-09-20
主题:"停下来"第一次变成了一种公开的技术主张——同一天,一边是离技术最近的人集体出走,一边是数学界自己去建开放模型 今天最重的一条不是模型发布,而是一场关于"该不该慢下来"的公开辩论终于有了形状。四个月内,两位一线研究员先后从前沿实验室离职:从 Google DeepMind 出走的 Bilal
发布于 2026-09-19
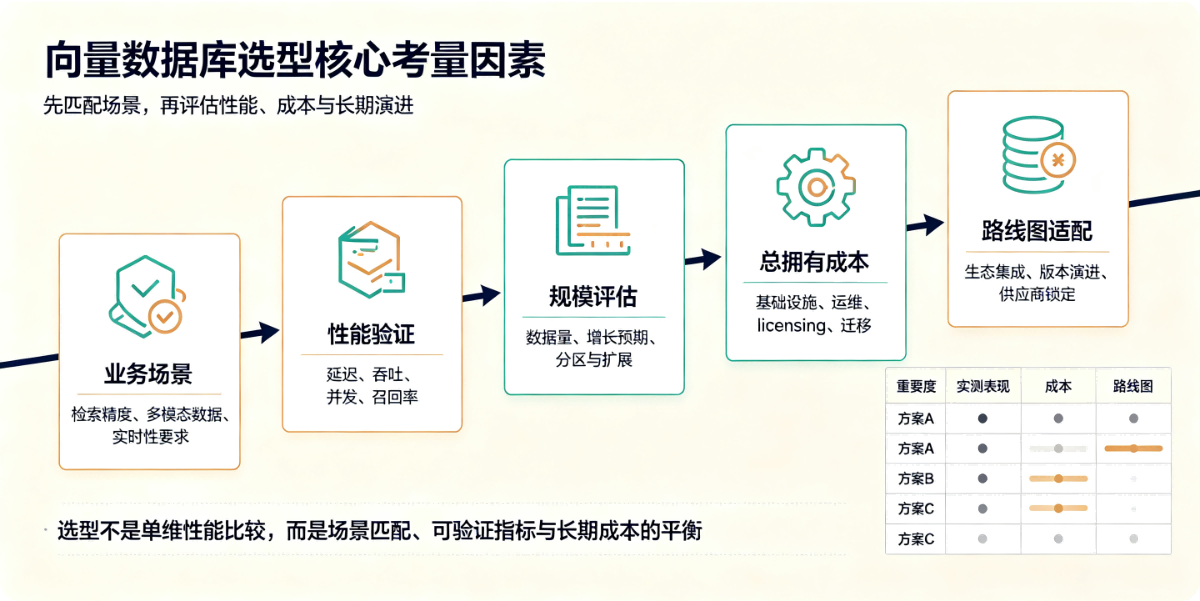
向量数据库本质是对高维向量做相似度检索 + 配套元数据管理,选型要从业务规模、检索性能、工程运维、成本、生态合规几个维度评估,下面分大类梳理,适合技术方案评审。 一、业务与向量本身特征(最先评估) 向量维度 低维(<256):大部分库都轻松支持; 中维(256~1024):主流 Embedding
发布于 2026-09-19

