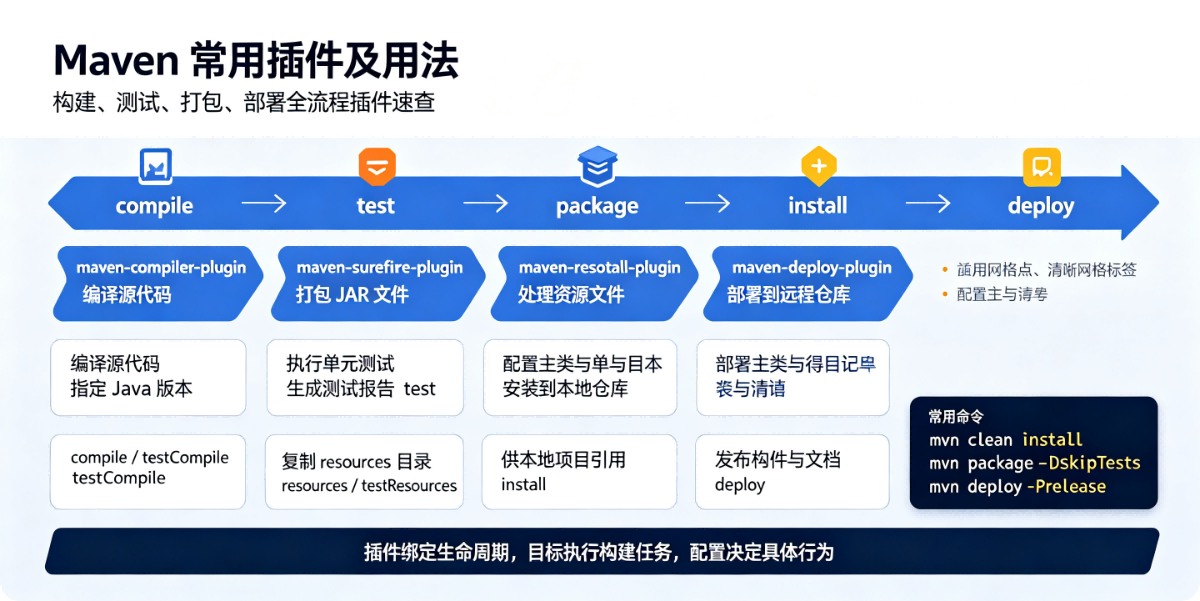
Maven 插件核心:插件目标 (goal),执行格式 mvn 插件前缀:目标;生命周期阶段会自动绑定对应插件目标。 插件配置写在 pom.xml 的 build/plugins 节点。 1. maven-compiler-plugin 编译插件(最常用) 作用:指定 Java 源码版本、编译版本、
 发布于 2026-09-19
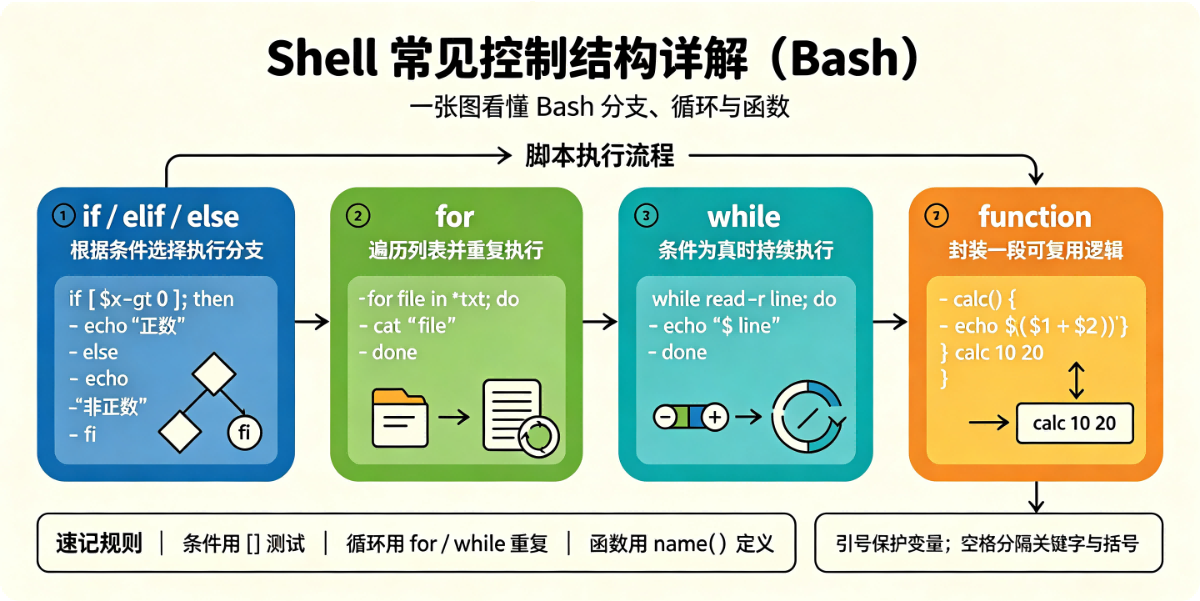
Shell 的控制结构分为条件判断、循环、分支选择、跳转四大类,核心就是 if、for、while、until、case、select,配合 break / continue。 注意:shell 语法坑很多,[ ] 本质是命令,括号两边必须有空格;; 用来分隔同一行多条语句。 一、条件判断:if /
发布于 2026-09-18
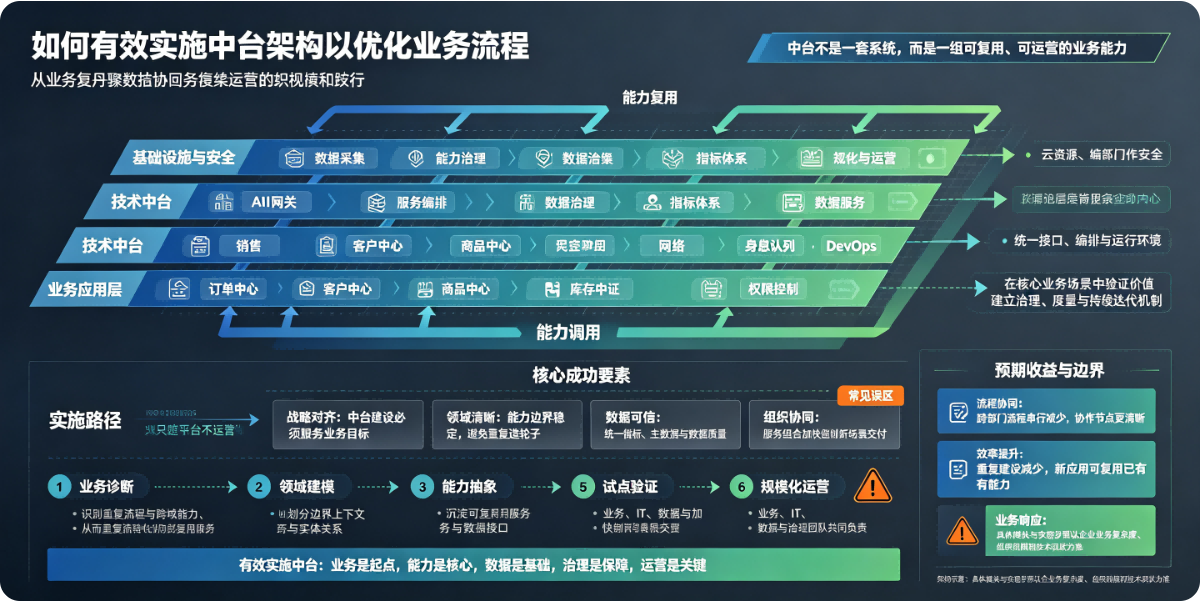
中台本质是能力复用、业务解耦、统一治理,不是单纯建一套技术平台。目标是把公共能力沉淀为可复用服务,减少重复开发、打通数据壁垒,从而简化业务流程、提升业务响应速度。实施中台最大坑:为中台而中台,重平台建设、轻业务流程梳理,最后变成厚重的技术包袱。 核心思路:业务先行 → 领域拆分 → 能力沉淀 → 平
发布于 2026-09-18
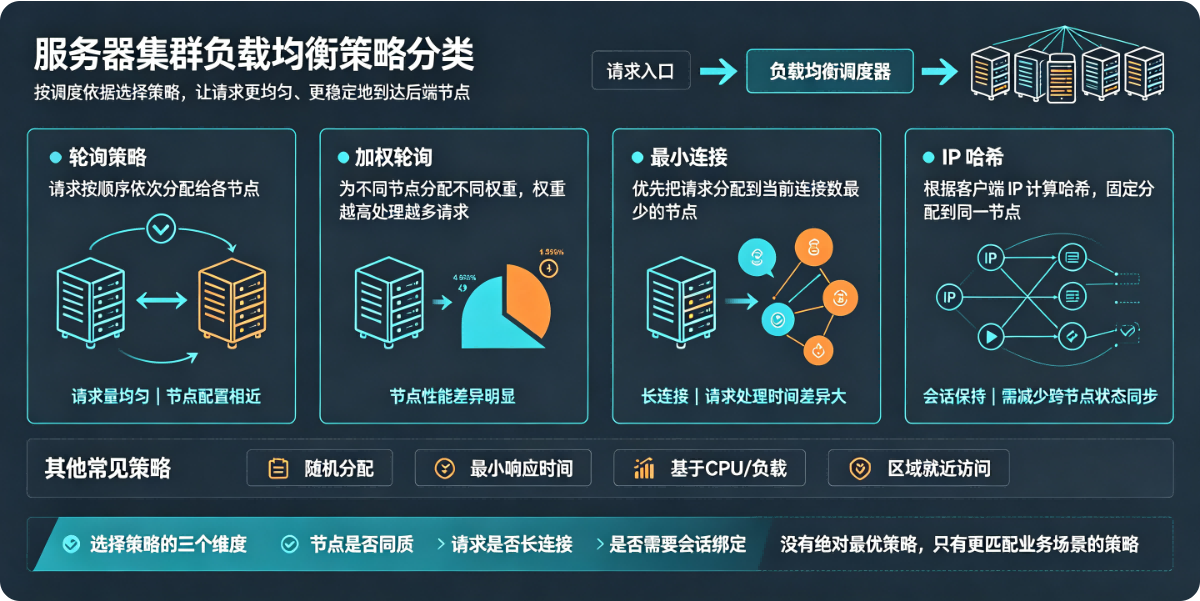
负载均衡策略一般分为静态策略(不感知后端真实负载) 和动态策略(根据后端实时状态调度),不同组件(Nginx、LVS、HAProxy、云 LB、K8s Service)支持的策略略有差异。 一、静态负载均衡策略 调度规则提前定义,不检查后端服务器当前连接数、CPU、内存,只按算法分发请求。 1. 轮
发布于 2026-09-18
题:同一天里,Agent 被同时推向了两个相反的方向——一边涌向云端军团,一边学会"不做生成" 今天最值得记的不是某个模型又涨了多少分,而是 Agent 的基础假设在同一天被两拨人从相反方向推开。Anthropic 把 Claude Code 的项目功能重构成云端"协调器 + 工作线程":一个目标下
发布于 2026-09-18
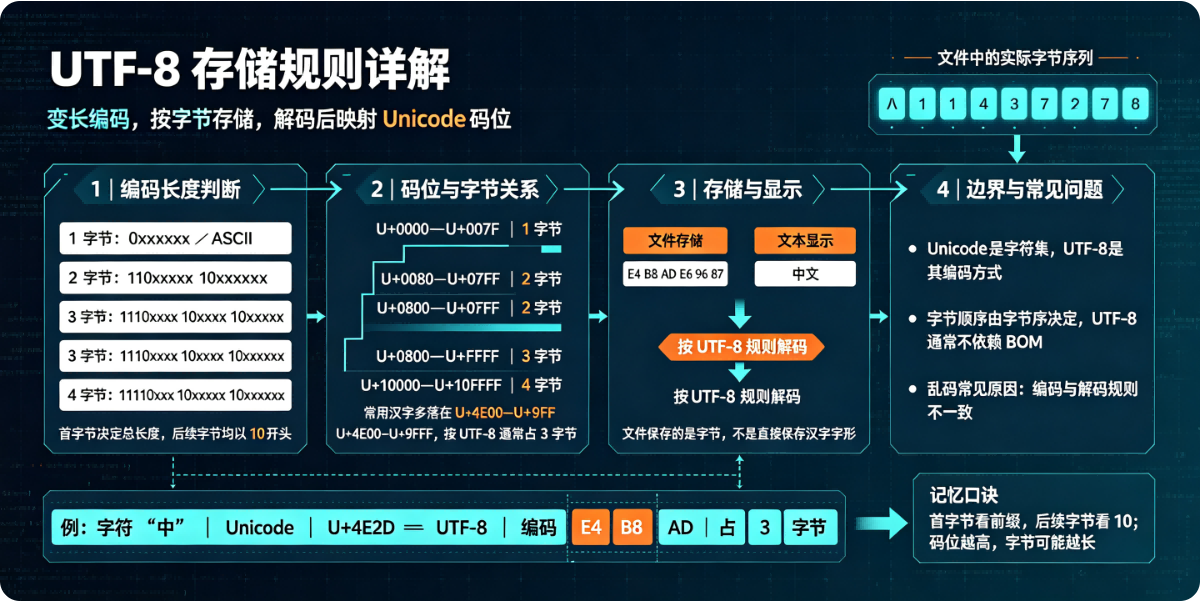
UTF-8 是变长编码,用 1~4 字节 表示一个 Unicode 码点,兼容 ASCII(0~127)。 核心原则: 单字节字符:最高位为 0,和 ASCII 完全一致 多字节字符:第一个字节开头标记总长度,后续每个字节固定以 10 开头(续字节) 编码格式模板(二进制)
发布于 2026-09-18
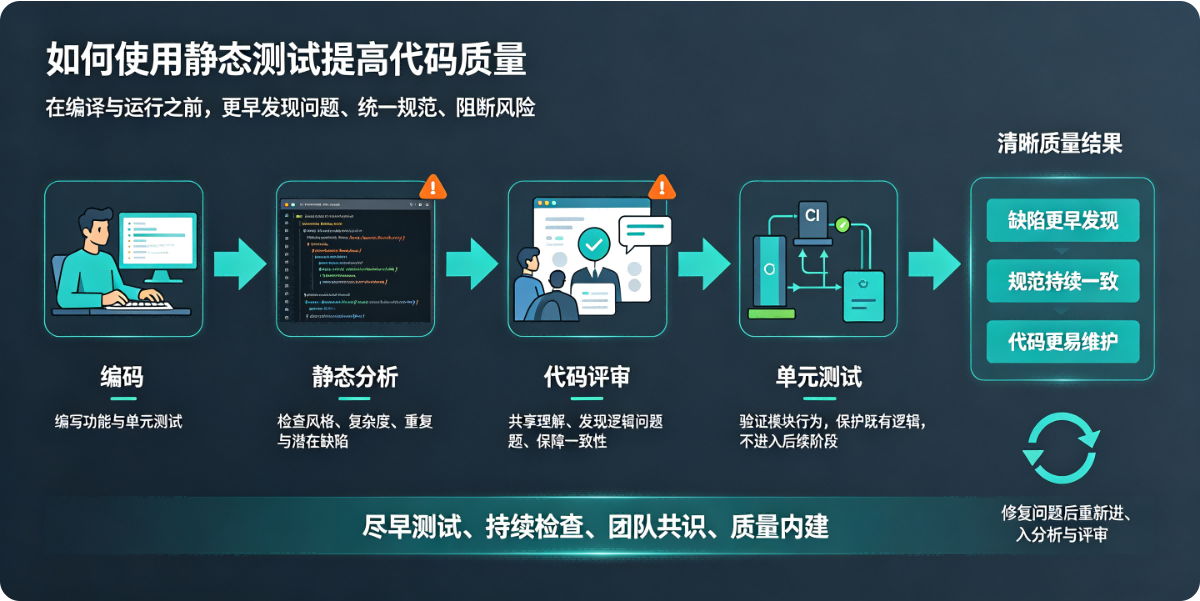
静态测试:不运行程序,直接对源代码、文档、配置进行检查分析,在编码阶段提前发现缺陷,避免缺陷流入编译、测试、上线阶段。 核心价值:早发现、低成本,捕获语法、规范、安全、复杂度、坏味道问题。 一、静态测试包含哪些手段 代码审查(人工静态):Code Review 静态代码分析工具(自动化静态):Lin
发布于 2026-09-18
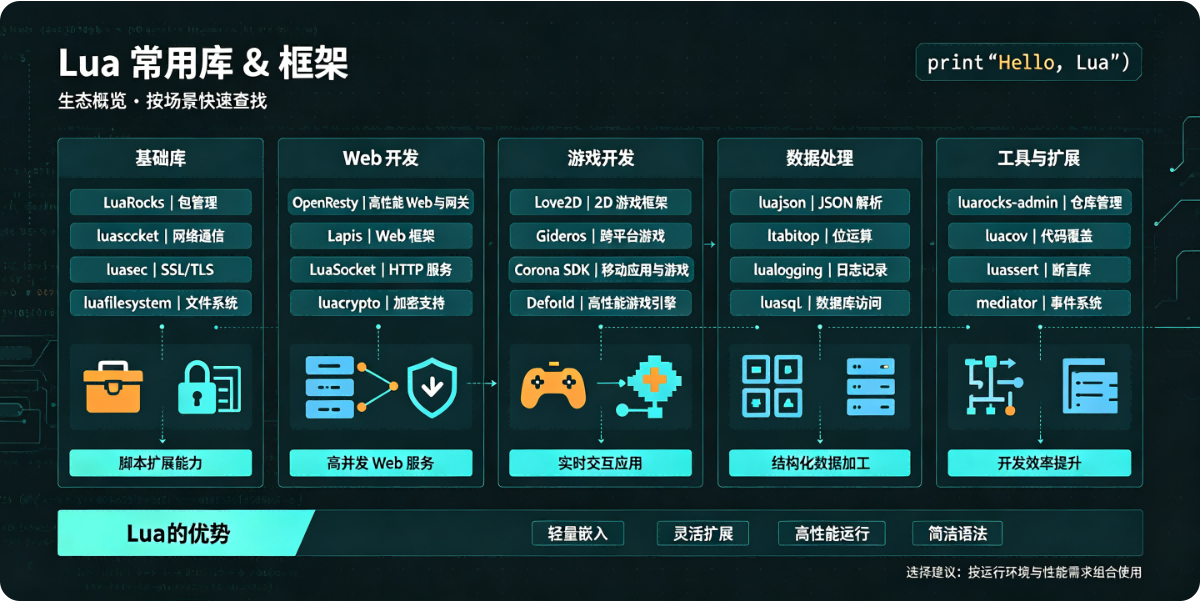
Lua 本身很小,标准库只提供基础能力,绝大多数能力靠第三方库;生态主要集中在:Web 网关、游戏、嵌入式、通用工具四大领域。 包管理器:LuaRocks(Lua 的 pip,安装第三方库) 一、Lua 内置标准库(原生自带,无需安装) base:基础函数 print / pcall / requi
发布于 2026-09-18
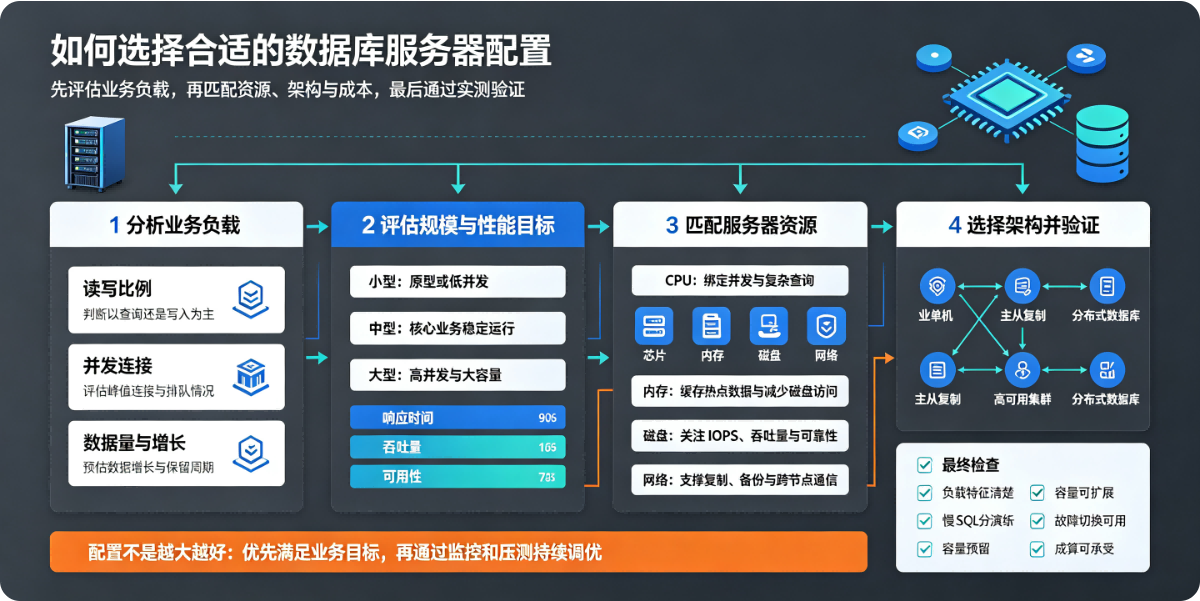
核心思路:先评估业务负载类型、数据量、并发、SLA,再匹配 CPU / 内存 / 磁盘 / 网络,最后区分物理机、虚拟机、容器、云数据库选型,不要上来直接堆硬件。 一句话原则:数据库绝大多数场景是内存优先,其次磁盘 IO,CPU 看计算压力。 一、第一步:明确业务需求(选型前置) 1. 业务类型
发布于 2026-09-17
主题:RSI 一天之内交了三次卷,而"自己优化自己"第一次有了生产环境的账单 今天是一个很难得的日子:RSI(递归自我改进)这个长期停留在论文与愿景里的词,在 24 小时内被三家公司用可验证的工程结果同时接管——智谱让 GLM-5.3 驱动的 Infra Agent 在 10 万张国产芯片上从零搭出
发布于 2026-09-17
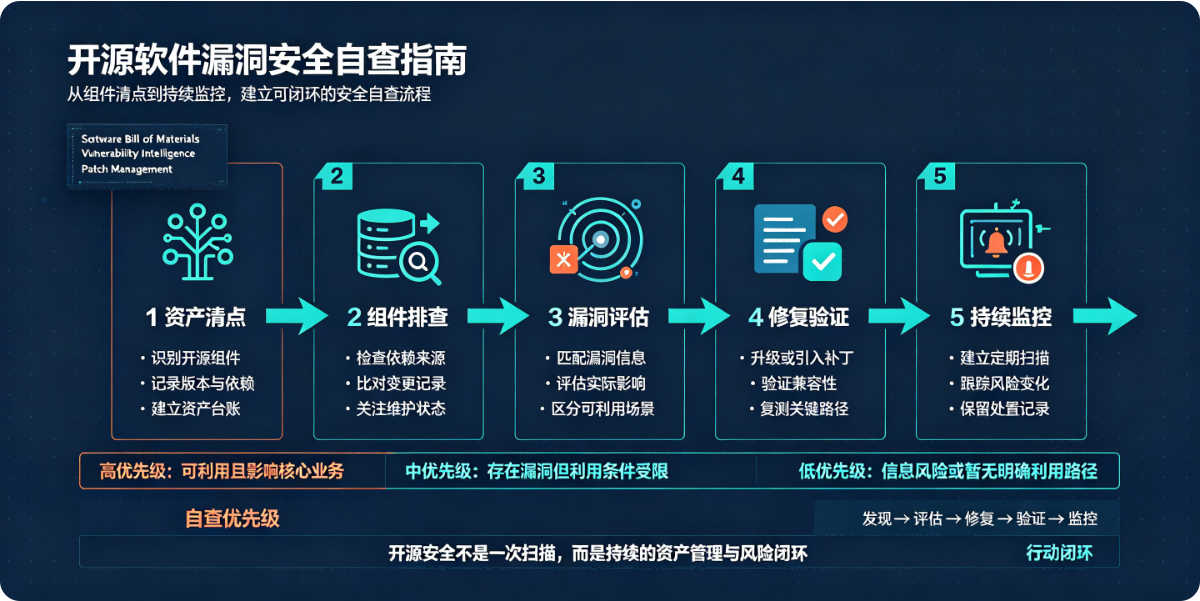
适用:Java/Python/Go/JS 等项目、容器镜像、CI 流水线、业务系统;目标:识别开源组件漏洞、许可证风险、供应链投毒,落地常态化自查,满足等保、信创、数据安全合规要求。 核心思路:清单梳理 → 漏洞扫描 → 风险定级 → 验证修复 → 基线管控 → 持续监控 一、自查前置准备
发布于 2026-09-17
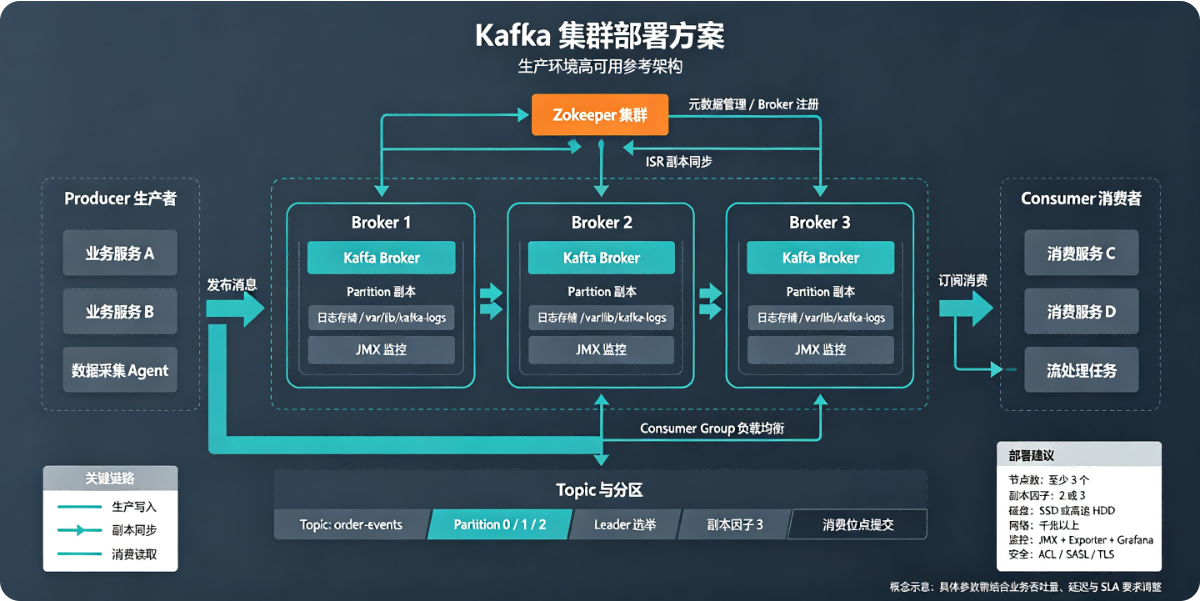
一、方案概述 1.1 目标 搭建一套高可用、可扩展、支持业务消息生产消费的 Apache Kafka 集群,用于实时数据采集、消息队列、流计算(对接 Flink/Spark)、日志上报等场景;配套 ZooKeeper(Kafka 2.8+ 支持 KRaft 无 ZK 模式,方案同时提供两种选型)。
发布于 2026-09-17
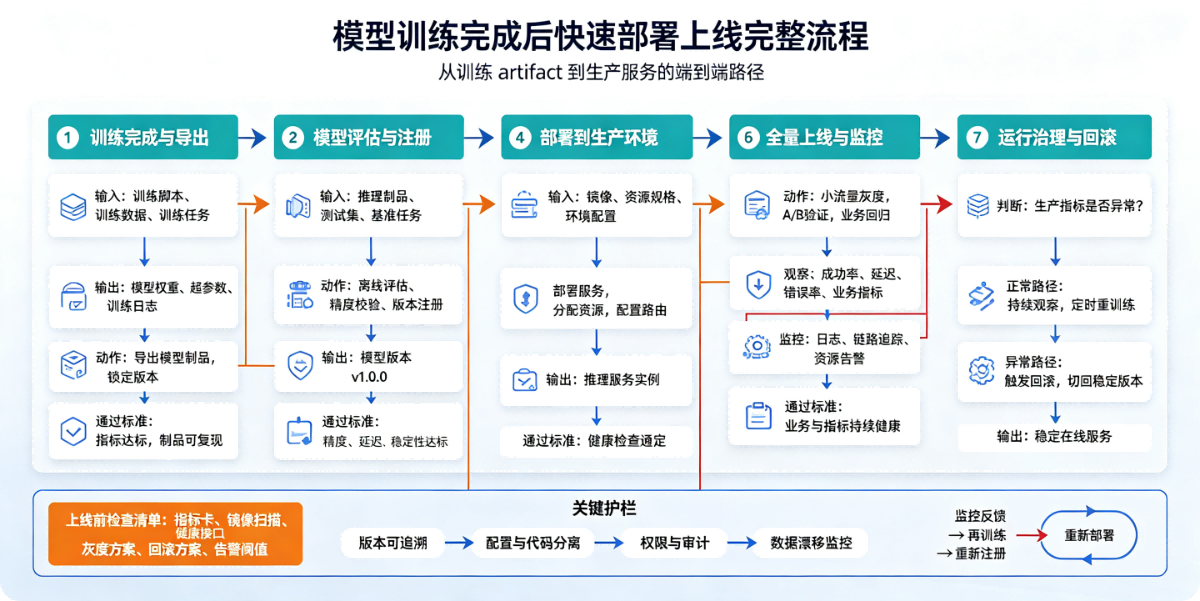
核心思路:模型导出 → 验证推理 → 封装服务 → 部署运行 → 监控灰度,根据场景选轻量 / 生产级方案,优先复用成熟工具减少重复造轮子。下面分通用流程、不同方案选型、踩坑点。 一、第一步:训练收尾 & 模型导出(最容易忽略) 训练框架(PyTorch/TensorFlow/Paddle)原生权重
发布于 2026-09-17
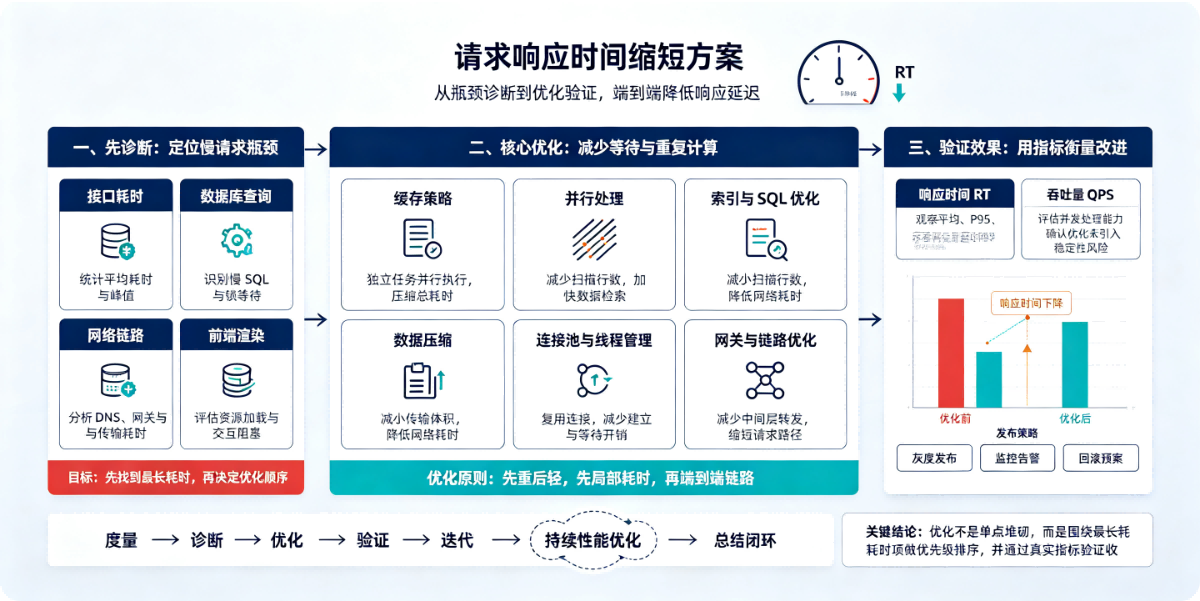
请求响应时间(RT)一般由:客户端网络 → DNS → TCP 握手 → 服务端处理 → 数据库 / 中间件 IO → 网络回包 → 客户端渲染 多段组成,优化思路按「由外到内、先瓶颈后细节」。 公式:总RT = 网络耗时 + 服务处理耗时 + 下游依赖耗时 + 序列化/反序列化耗时 一、网络层优化
发布于 2026-09-17
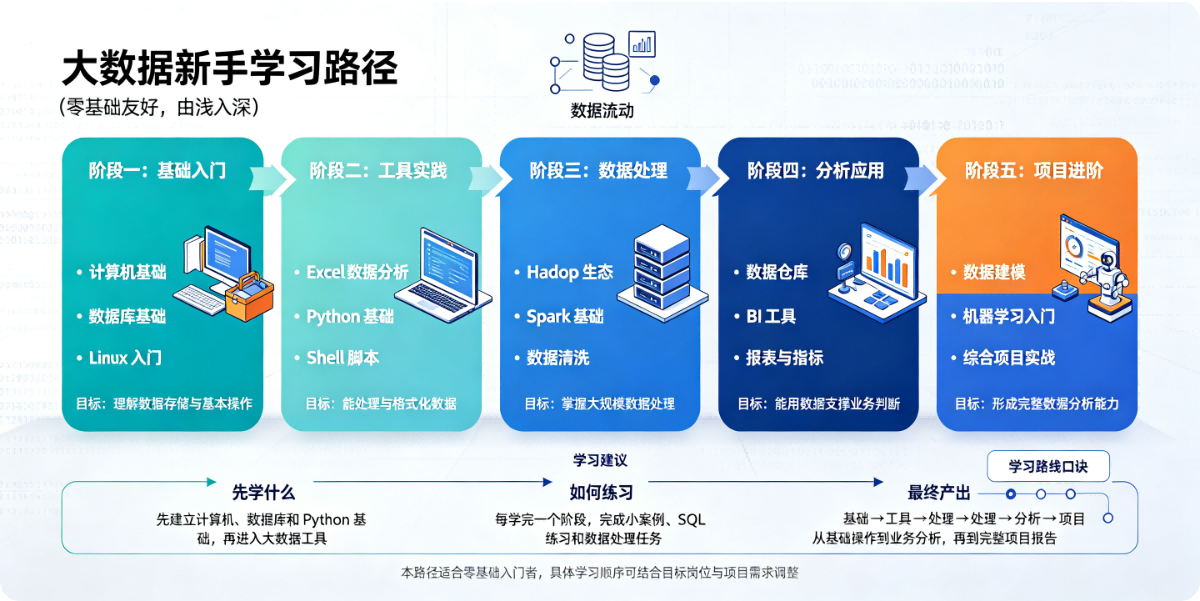
整体思路:夯实计算机基础 → 掌握大数据核心组件 → 实战项目 → 方向细分(开发 / 数仓 / 数据分析) 阶段 1:前置基础(1~2 个月,重中之重) 大数据不是孤立技术,底层是 Linux、数据库、编程基础,新手跳过这一步极易卡在组件部署。 Linux:优先学 CentOS/openEuler
发布于 2026-09-17
2026-09-16 正式发布 · Apache 2.0 · 32,000+ Stars · 270 万+ 部署实例 · 160+ 全球贡献者 · NVIDIA Inception 成员 🔥 一、新闻速览:从第一行代码到生产就绪 9 月 16 日,国产开源分布式对象存储 RustFS 正式发布 1.
发布于 2026-09-17
主题:Agent 开始要求"基础设施级待遇" 字节把 Agent 放进协同办公底座(飞书 8.0 系统性"for Agent"改造 + 豆包工作伙伴,中国首个团队智能体产品);华为 GTS 把"可交互视觉拓扑"做成 Agent 的外部工作记忆以治"拓扑失忆";Cloudflare 为"被收录"与"被
发布于 2026-09-17

