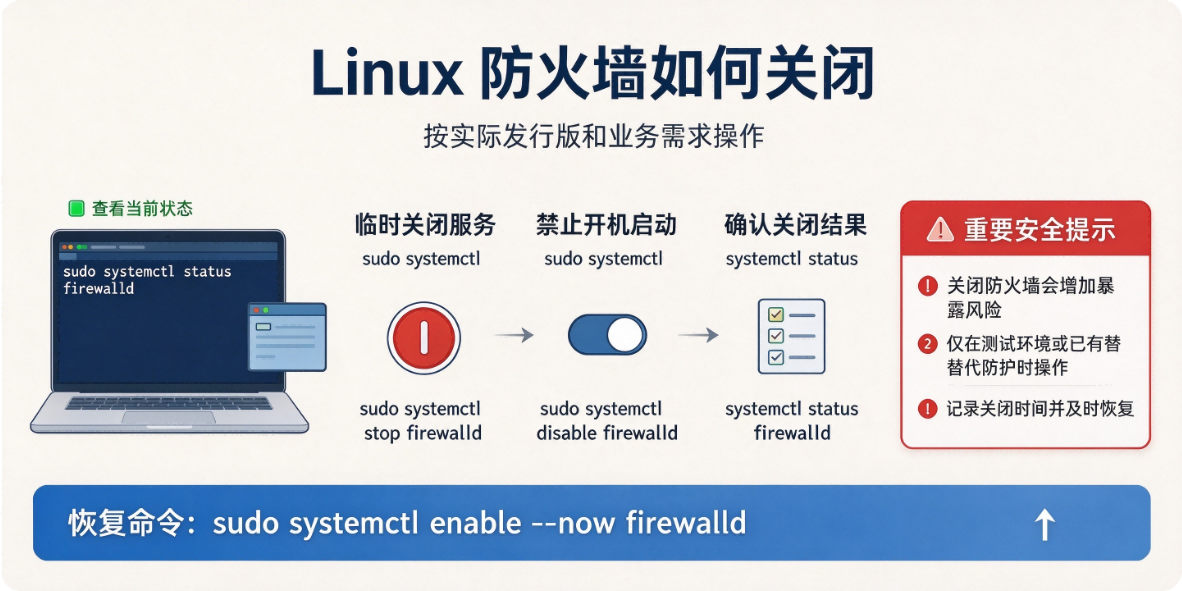
⚠️重要提醒 生产环境不建议直接关闭防火墙,最好是放行端口;关闭仅用于本地测试、集群实验环境。云服务器还要注意云厂商安全组,系统防火墙关了安全组依旧会拦截端口。 一、CentOS7+/RHEL7+/Alibaba Linux(firewalld) # 查看状态 systemctl status fi
 发布于 2026-10-17
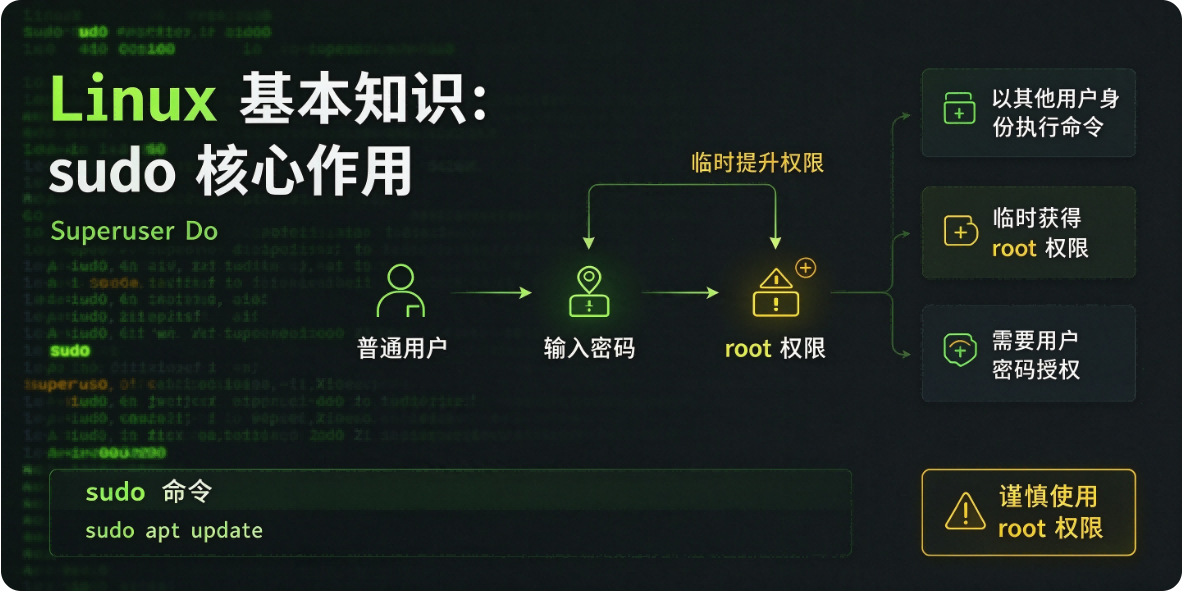
sudo = substitute user do,简单说:以其他用户身份执行一条命令,默认是 root(超级管理员)身份。 核心要点 不是永久切换 root,只临时提权 su 是切换整个会话为 root; sudo cmd 仅这一条命令用管理员权限执行,执行完权限回归普通用户。 权限受控 由 /e
发布于 2026-10-17
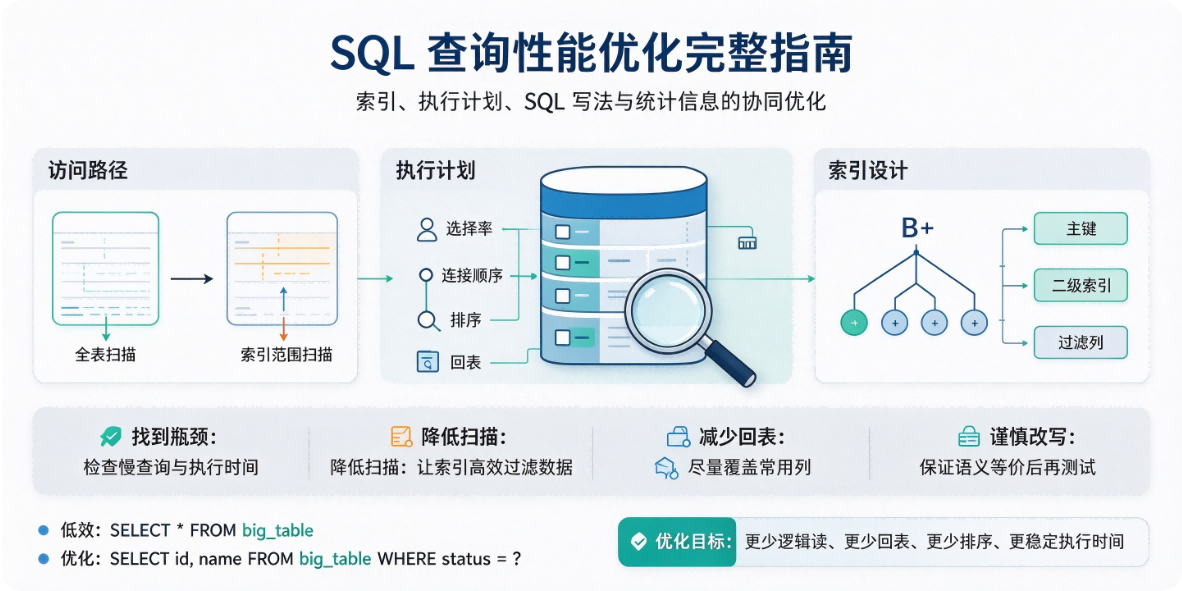
优化思路分为 4 大块:SQL 语句本身优化、索引优化、数据库表结构设计、执行计划与数据库配置,优先从执行计划入手定位瓶颈,不要盲目加索引。 一、先看执行计划(定位问题的第一步) MySQL:EXPLAIN SELECT ... PostgreSQL:EXPLAIN ANALYZE SELECT .
发布于 2026-10-17
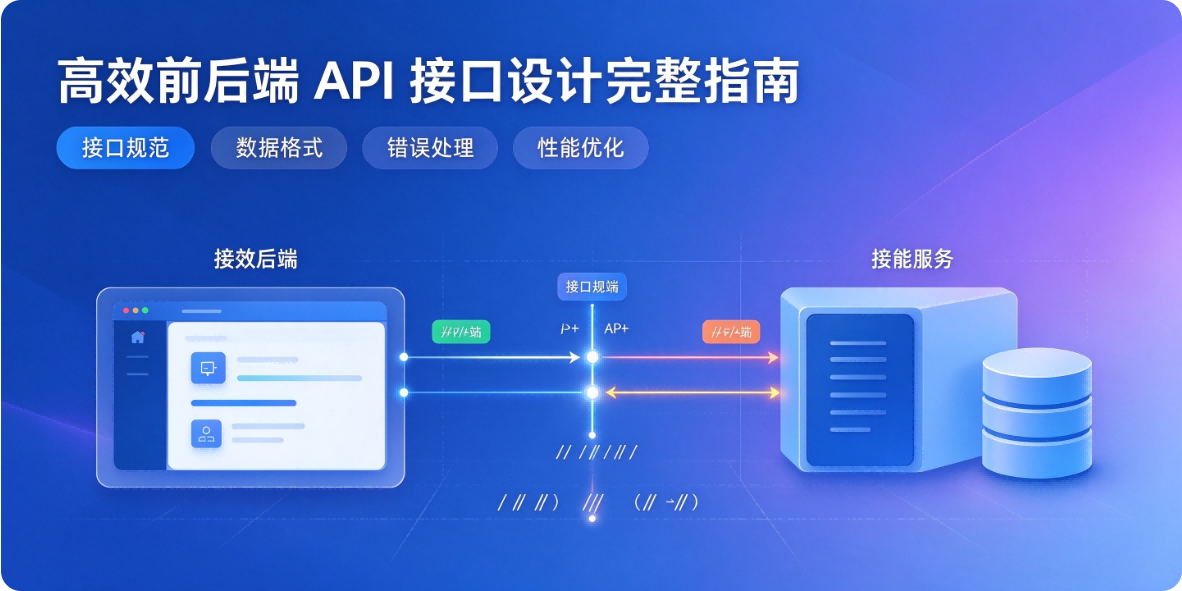
核心目标:降低联调成本、减少网络开销、便于版本迭代、易于排查问题、保障安全,下面从规范、数据结构、性能、错误处理、版本、安全、工程实践完整梳理,适合团队落地。 一、接口风格选型 RESTful(最通用,CRUD 场景) 资源用名词复数,不要动词 ✅ GET /users 获取用户列表 ✅ GET /
发布于 2026-10-17
数据清洗的核心目标:修正脏数据、降低噪声、消除数据偏差,让模型学到真实规律而不是数据里的错误和干扰,一般按「评估 → 识别问题 → 清洗处理 → 验证闭环」流程落地。 一、先做数据探查与质量评估(清洗前必做) 不先摸底直接清洗很容易破坏有效信息。 基础统计探查 数值字段:均值、中位数、分位数、方差、
发布于 2026-09-20
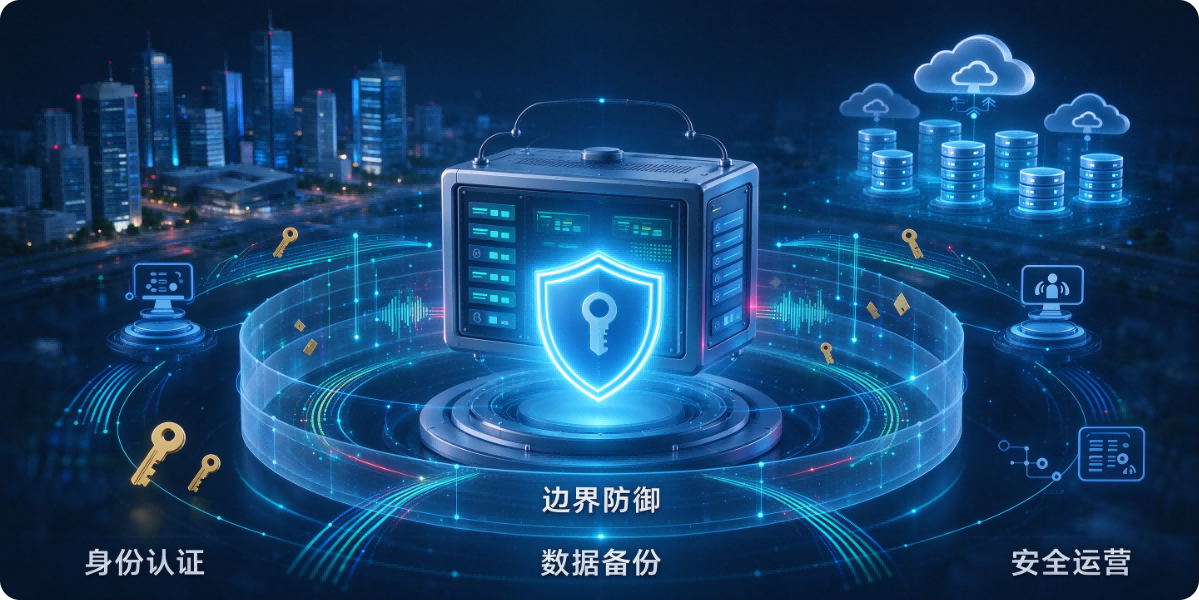
企业级数据安全不是单一产品,而是制度 + 人员 + 技术 + 运营 + 合规的完整闭环,覆盖数据采集、传输、存储、使用、共享、销毁全生命周期。下面从顶层框架、全生命周期技术手段、权限与访问控制、基础设施安全、审计与应急、合规治理几个维度说明。 一、顶层治理:先建立管理体系(安全的根基) 数据分级分类
发布于 2026-09-20
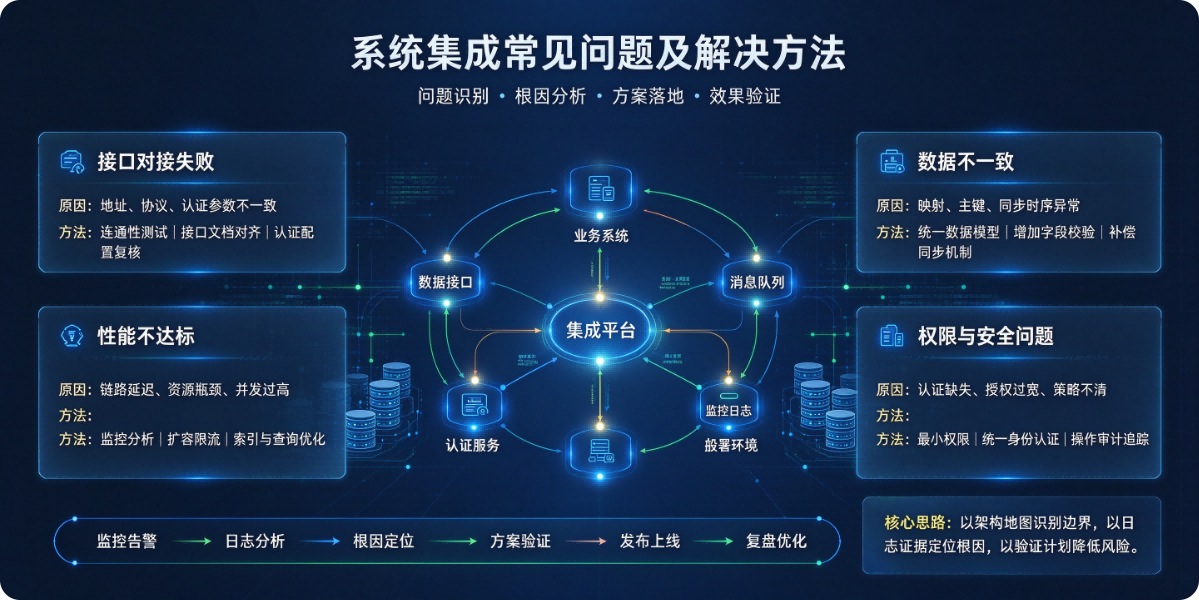
系统集成本质是把硬件、软件、网络、业务系统、第三方接口打通,实现数据互通、业务联动;痛点大多集中在接口、数据、兼容性、性能、运维、需求管理六大类,下面按类别整理问题、原因、解决方案,适合方案编写、汇报、故障排查。 一、接口对接问题(最常见) 1. 接口协议不统一 现象:A 系统用 HTTP/JSON
发布于 2026-09-20
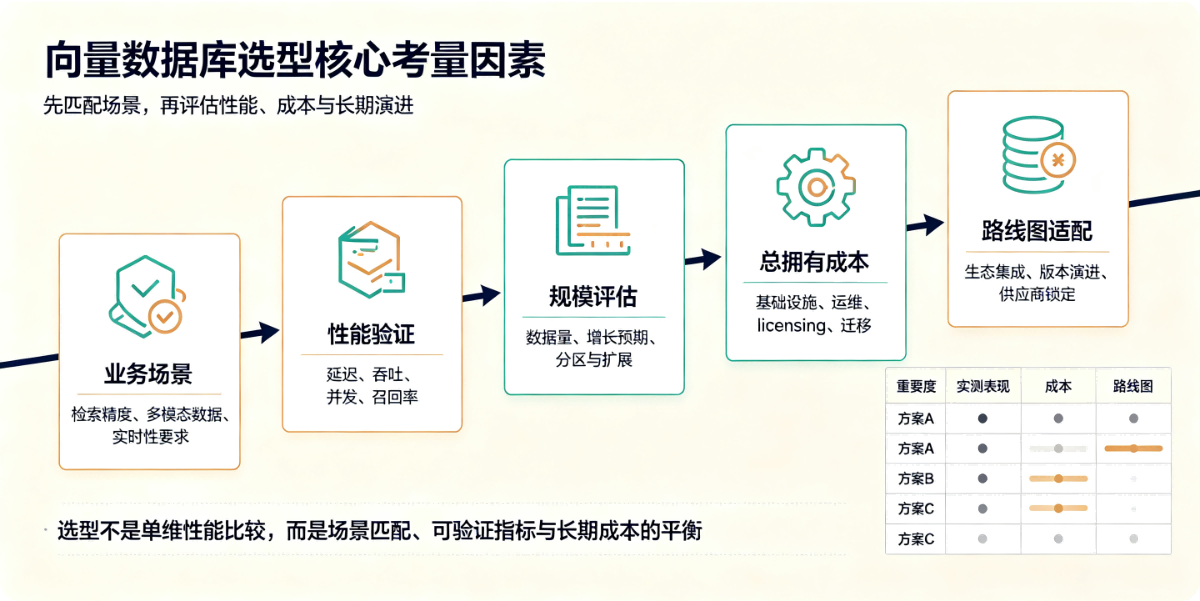
向量数据库本质是对高维向量做相似度检索 + 配套元数据管理,选型要从业务规模、检索性能、工程运维、成本、生态合规几个维度评估,下面分大类梳理,适合技术方案评审。 一、业务与向量本身特征(最先评估) 向量维度 低维(<256):大部分库都轻松支持; 中维(256~1024):主流 Embedding
发布于 2026-09-19
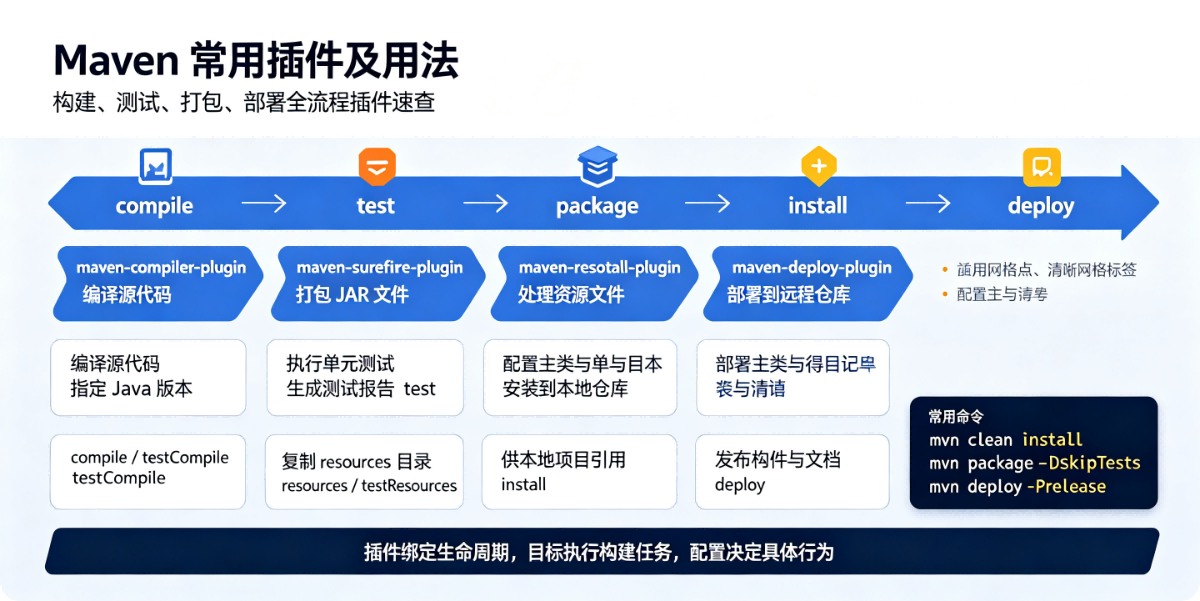
Maven 插件核心:插件目标 (goal),执行格式 mvn 插件前缀:目标;生命周期阶段会自动绑定对应插件目标。 插件配置写在 pom.xml 的 build/plugins 节点。 1. maven-compiler-plugin 编译插件(最常用) 作用:指定 Java 源码版本、编译版本、
发布于 2026-09-19
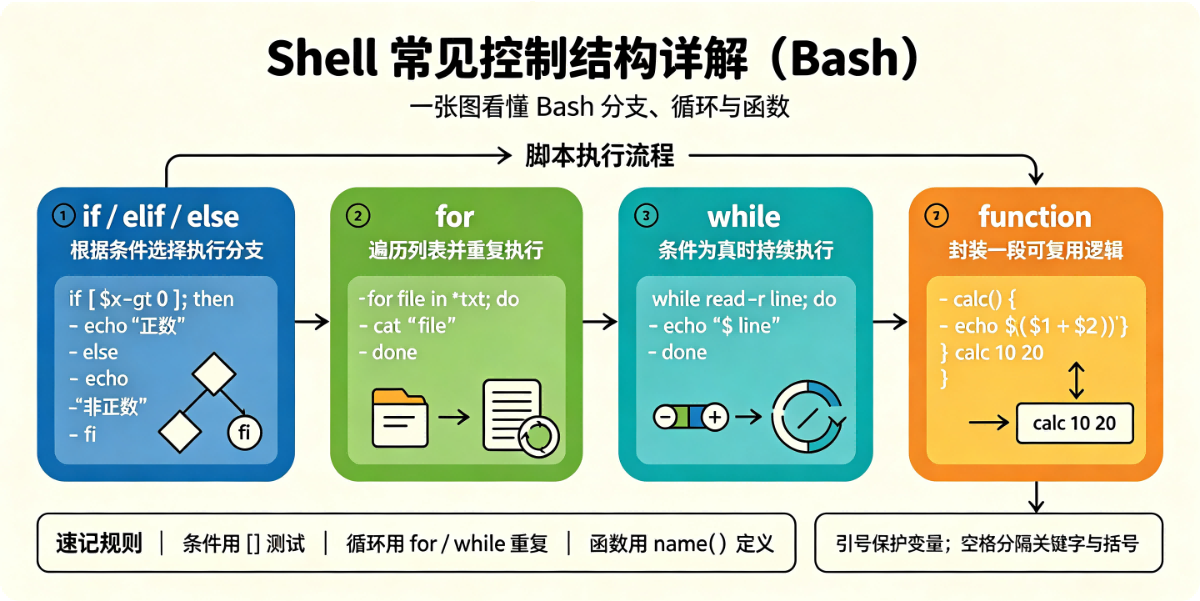
Shell 的控制结构分为条件判断、循环、分支选择、跳转四大类,核心就是 if、for、while、until、case、select,配合 break / continue。 注意:shell 语法坑很多,[ ] 本质是命令,括号两边必须有空格;; 用来分隔同一行多条语句。 一、条件判断:if /
发布于 2026-09-18
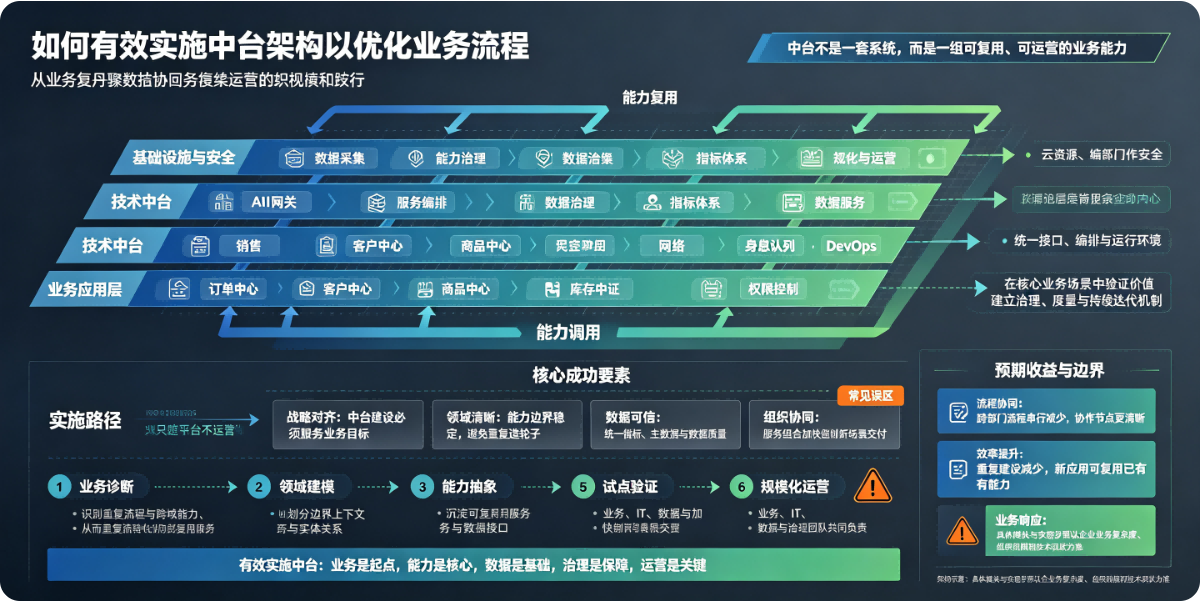
中台本质是能力复用、业务解耦、统一治理,不是单纯建一套技术平台。目标是把公共能力沉淀为可复用服务,减少重复开发、打通数据壁垒,从而简化业务流程、提升业务响应速度。实施中台最大坑:为中台而中台,重平台建设、轻业务流程梳理,最后变成厚重的技术包袱。 核心思路:业务先行 → 领域拆分 → 能力沉淀 → 平
发布于 2026-09-18
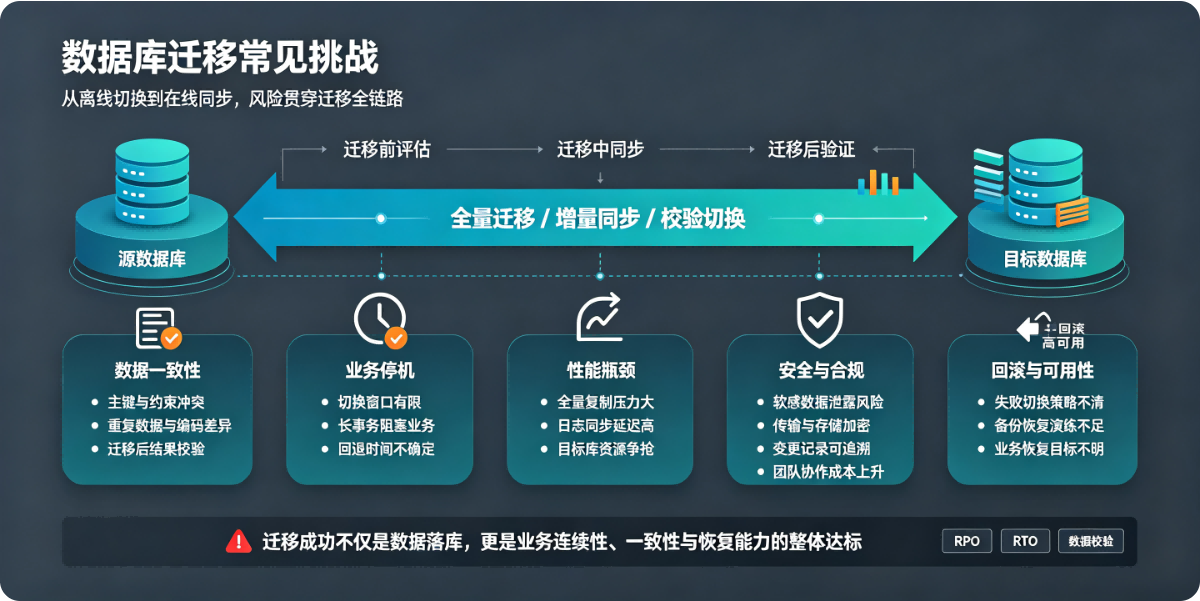
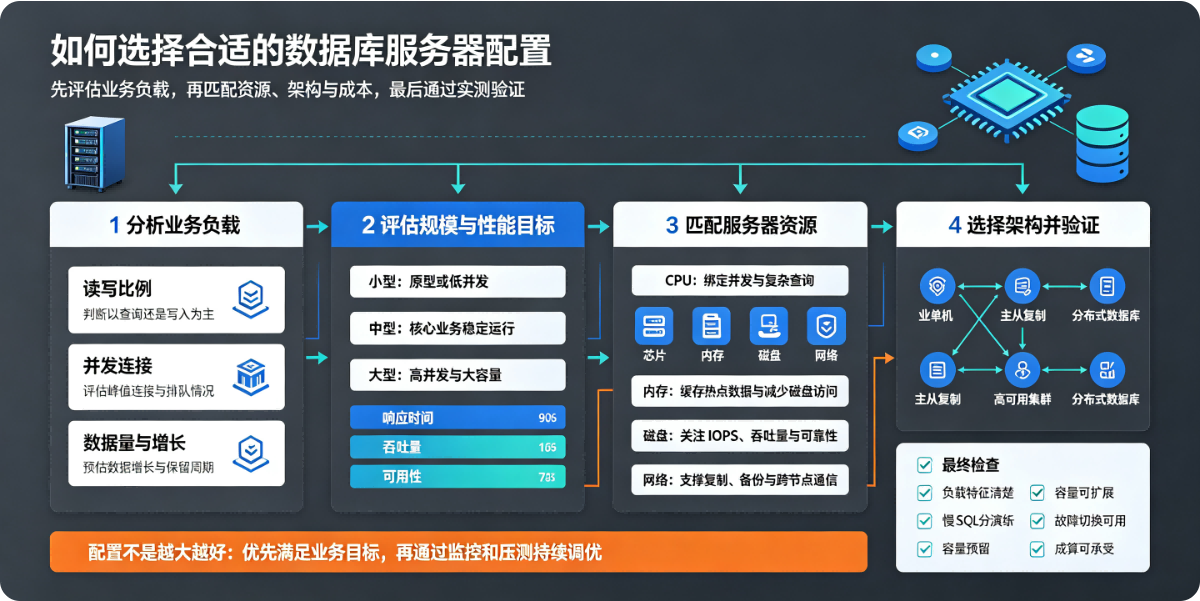
核心思路:先评估业务负载类型、数据量、并发、SLA,再匹配 CPU / 内存 / 磁盘 / 网络,最后区分物理机、虚拟机、容器、云数据库选型,不要上来直接堆硬件。 一句话原则:数据库绝大多数场景是内存优先,其次磁盘 IO,CPU 看计算压力。 一、第一步:明确业务需求(选型前置) 1. 业务类型
发布于 2026-09-17
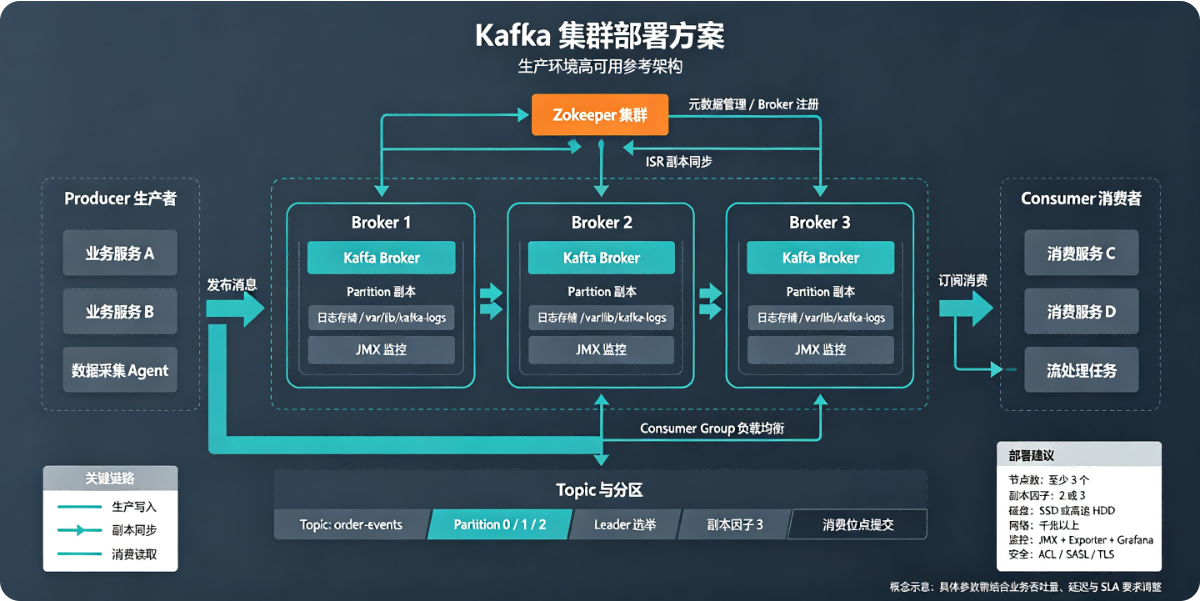
一、方案概述 1.1 目标 搭建一套高可用、可扩展、支持业务消息生产消费的 Apache Kafka 集群,用于实时数据采集、消息队列、流计算(对接 Flink/Spark)、日志上报等场景;配套 ZooKeeper(Kafka 2.8+ 支持 KRaft 无 ZK 模式,方案同时提供两种选型)。
发布于 2026-09-17
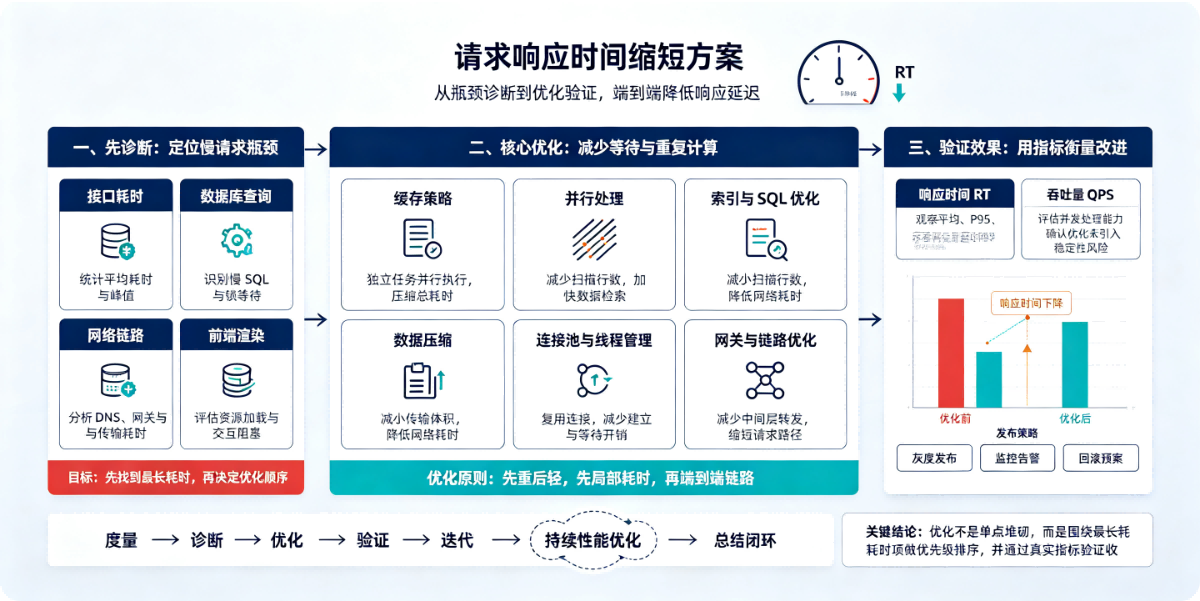
请求响应时间(RT)一般由:客户端网络 → DNS → TCP 握手 → 服务端处理 → 数据库 / 中间件 IO → 网络回包 → 客户端渲染 多段组成,优化思路按「由外到内、先瓶颈后细节」。 公式:总RT = 网络耗时 + 服务处理耗时 + 下游依赖耗时 + 序列化/反序列化耗时 一、网络层优化
发布于 2026-09-17
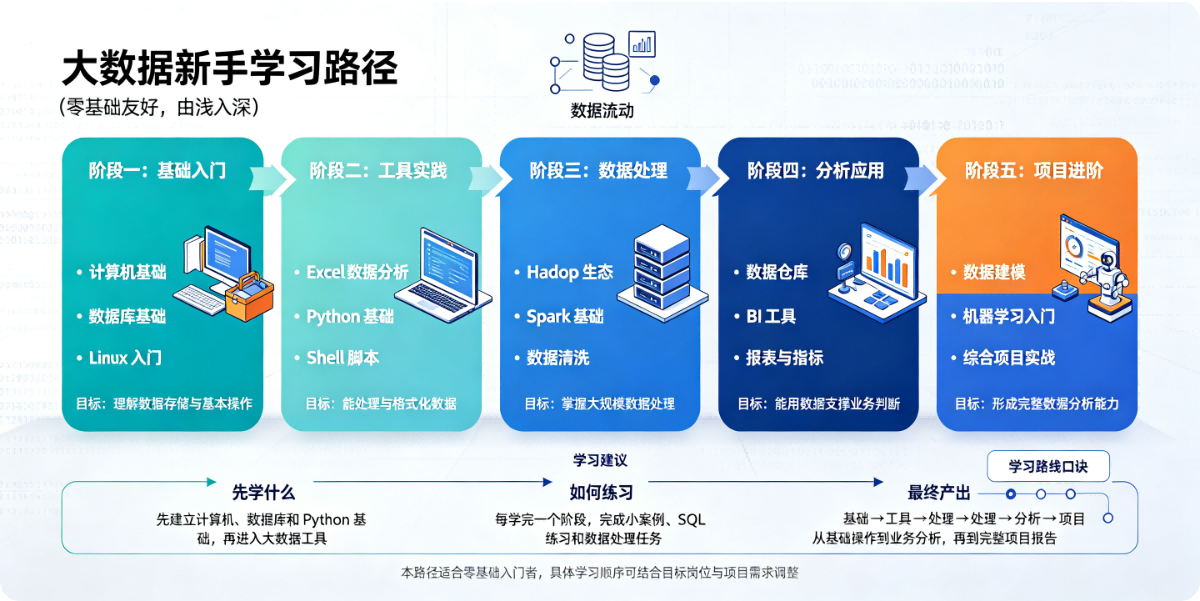
整体思路:夯实计算机基础 → 掌握大数据核心组件 → 实战项目 → 方向细分(开发 / 数仓 / 数据分析) 阶段 1:前置基础(1~2 个月,重中之重) 大数据不是孤立技术,底层是 Linux、数据库、编程基础,新手跳过这一步极易卡在组件部署。 Linux:优先学 CentOS/openEuler
发布于 2026-09-17
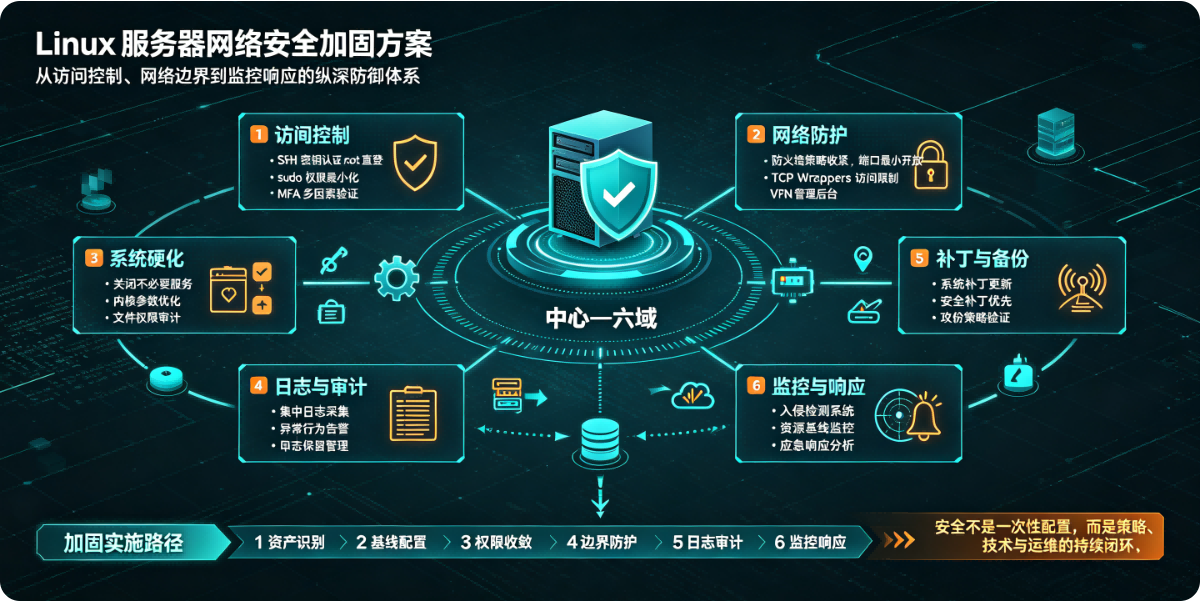
按基础系统加固 → 网络层防护 → 服务与应用安全 → 日志审计 → 应急运维分层整理,可直接落地,适合线上服务器(CentOS / Debian /openEuler/ Ubuntu)。 一、系统基础加固(最优先做) 1. 用户与账号安全 禁用 root 远程登录 # /etc/ssh/sshd_
发布于 2026-09-16
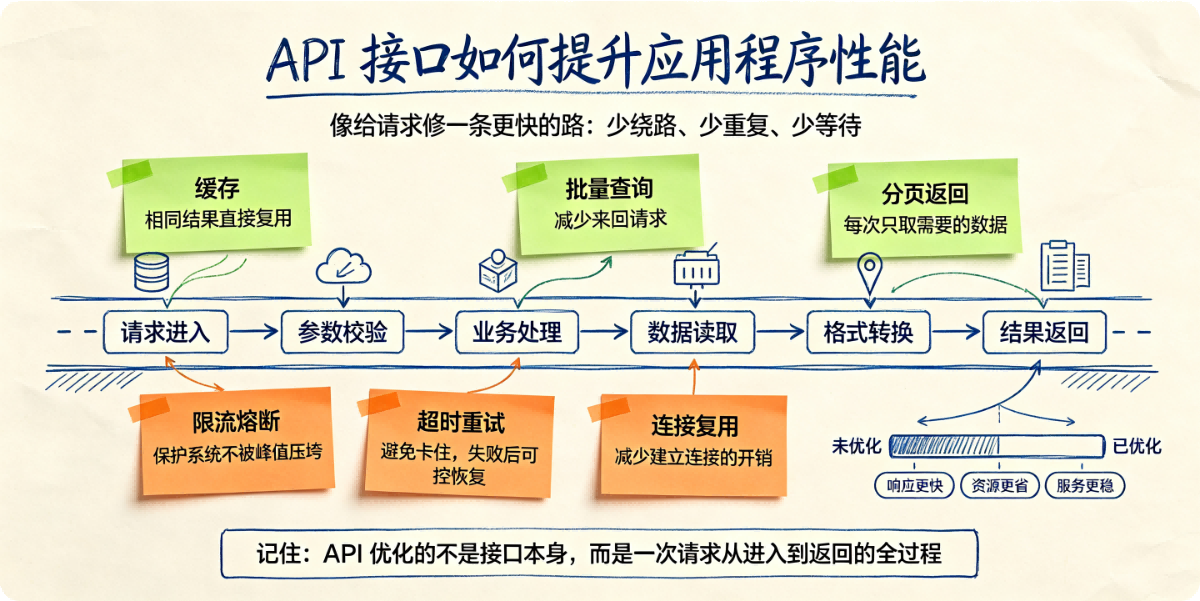
API 本身是系统间通信契约,合理的 API 设计、调用策略、服务架构可以大幅降低延迟、减少资源消耗,提升整体应用性能;反过来糟糕的 API 会拖垮整个系统。下面分接口设计、调用方式、服务侧优化、客户端优化、架构层面来讲,附带落地要点。 一、API 接口设计层面(治本) 1. 按需返回数据,
发布于 2026-09-16

